以小博大,一家AI4S水下公司的野心

文|胡香赟
编辑|海若镜
今年5月,28岁的张载熙结束普林斯顿的博后研究,回到国内。在他面前,有几扇门同时打开:美国高校教职、AI大厂首席科学家和千万年薪。最终,他选择进入香港科技大学担任助理教授,并挺进了创业窄门,创立AI for Science公司科理新序(Scinetics)。
暗涌Waves独家获悉,科理新序近日完成近5000万元人民币融资。本轮融资由英诺科创基金领投,沂景资本、小苗朗程、麟阁创投跟投。
这或许是他既往人生中,为数不多的岔路口。从中科大少年班、直博,到哈佛医学院联合培养,随后进入普林斯顿王梦迪团队做博后。研究AI4S的青年PI,是当下创投市场最喜欢的创业者画像之一。
但创业的决策过程,他也曾纠结。
进入大厂,意味着更充足的算力、数据和人才配置;成为高校PI并创业,要比较独立地找人、找钱、找资源,技术和商业都有不确定性。
最终让张载熙下定决心做出选择的是“工作自主性”,他想主导自己的研究方向,而不是被更大的公司组织约束。他更享受从零搭建一套体系的过程。
创业前,张载熙和团队曾经做出过科学智能体Stella。去年,Stella上线后,服务了上千名科研用户,其中七成以上来自斯坦福、普林斯顿等高校和顶级实验室。相比自训基座模型,智能体落地更快、更容易接入现有研发流程,实现商业化。
不过,这条轻巧的路线,目前仍有局限。以大语言模型作为推理引擎,科学智能体在遇到蛋白质结构、核酸序列等数据时,会先将问题翻译为“自然语言”,再把文字指令交给模型执行。精细的三维结构和模态关系,在几次翻译转换中会出现“损耗”,智能体几十次交互也无法绕开误差。
博士期间,张载熙曾开发分子筛选模型MGSSL、药物分子生成模型FLAG等,在多个细分领域达到SOTA。但他判断,单点能力仍是不够,未来AI4S行业会集体走向多模态。所以,科理新序的核心是做多模态长程推理基座模型。
他提出了“Science Token”概念,希望把小分子、核酸、蛋白质结构等科学数据,转化成模型统一的表征单元,不再经过人类语言的转译,让模型在原生科学模态中推理,完成科学任务。
短期,他们将聚焦商业化路径最清晰的生命科学,未来逐步拓展至材料、工程等科学领域。
谈起未来,张载熙认为AI4S一定会出现GPT时刻、Coding时刻,且这是一个可能超越Coding的市场;他也相信自己所带领的小小团队,有实力开发出“大一统”的科学底座模型,成为AI4S领域里对标
技术革命初期,路线没有收敛,创业者才有“以小博大”的机会。近日,我们和张载熙聊了聊,此时投入AI4S创业,他究竟想赌一个怎样的未来?
对话(经编辑):
AI4S,媲美Coding的万亿市场
暗涌Waves:2019年,你21岁,选择了AI for Science作为博士研究方向,现在回头看很有先见之明。这个赛道从冷变热,你的体感是怎样的?
张载熙:确实比较幸运,职业生涯转型刚好踩中了行业风口。
我读博阶段,这是一个非共识赛道,行业认知是“Science+AI”,AI是提升业务效率的附加算法工具,项目必须深度绑定具体药物管线,比如聚焦多肽药物,或只做蛋白质垂直模型。
现在AI4S朝着通用方向演进,市场普遍认为这个方向会迎来属于自己的“Coding 时刻”。写代码赋予了人类在数字世界创造事物的能力;AI4S则是在变革人类底层科学探索、发现新知识的能力,市场价值可以比肩甚至超越Coding。
从Alpha Fold从1到4的迭代,可以清晰看到AI能力正迅速变强。需要被研究的科学问题没有巨变,但新算法让过去难以建模、难以预测的任务,具备了解决条件,更多科学模态的纳入,让模型能力更强。
暗涌Waves:Science其实是覆盖非常广的方向,现在创业投资的主流技术路线有哪些,技术路径上有收敛的趋势么?
张载熙:客观说,现阶段的AI4S赛道噪声不小,AI4S从业者主要基于自己既往背景做布局,还没有在技术路线上形成共识,难以判定孰优孰劣。
首先是科学智能体,主要靠调用外部工具完成科学任务。优势是落地快、能迅速嵌入现有研发流程,商业验证周期短,因此诞生了不少初创公司。
大厂也都在做,如Anthropic的Claude Science、OpenAI 的GPT-Rosalind。不过,他们的主战场还是Coding等更general的方向,科学方向属于占位式布局、浅浅试探。
第二是虚拟细胞。受Arc Institute相关工作和论文影响,虚拟细胞从去年起热度暴涨。理论上,它在电脑里模拟细胞受药物、基因编辑后的变化,能提前批量筛掉无效候选,压缩研发时间和成本。行业期待很高,发展速度也比较快。
第三就是我们选择的AI4S基座模型方向。这是一种“自下而上”的路线,聚焦底层分子相互作用,从分子机制推导疾病、基因调控网络等上层现象。
暗涌Waves:去年你们上线了科学智能体Stella,据说反馈也不错,为什么没有选择这条更轻巧的路线?
张载熙:Stella去年上线后,服务了上千名科研用户,七成以上来自斯坦福、普林斯顿等名校和顶级实验室,MIT的张峰教授也使用过。
但我们发现,科学智能体范式有个根本性问题:
它本质上是把科学问题翻译成自然语言让模型理解,再翻译回结构指令让工具执行。很多精细的三维结构信息、多模态之间的微妙关联,会在翻译过程中丢失。
这是范式本身的天花板。你当然可以在智能体框架上不断加工具、加流程,但只要底层推理还基于文本完成,这个瓶颈就一直在。
暗涌Waves:可以举一个智能体做不出来的例子么?
张载熙:比如蛋白质局部结构优化。要把某个侧链朝特定角度旋转5度,形成氢键或者其他分子相互作用,这高度依赖3D空间的精细推理设计。
如果用智能体做,就是让大语言模型输出文本指令,再调用RF diffusion这类结构扩散模型去执行。但结构模型本身没办法很好理解文本信息,工具输出结果又要转成字符串、截图,再反馈回大语言模型,智能体读得云里雾里,好像对,又好像不太对,只能继续迭代。
就这个步骤,我们尝试了很多智能体,反复交互过几十遍,浪费了大量Token,结果是跑了一堆用不了的东西。根源就是,没有原生的科学模态推理能力。
小天才的大梦想:多模态科学底座模型
暗涌Waves:所以你认为必须开发AI4S基座模型?有了基座模型,可以解决“跨模态翻译”问题?
张载熙:既然翻译会产生损耗,就不翻译了,让模型直接在原生科学模态空间内,做针对多模态科学数据的长程推理(Chain of Science Tokens)。这一基座模型,也是我们公司的核心产品。
我们针对组学、蛋白质结构、分子化学式、核酸序列等各类科学模态,开发了离散Token化方案,把各类科学信息转化为统一的Science Token输入模型,不再依赖人类自然语言做抽象中转,更贴近科学本质。
模型训练分预训练、mid-training、后训练三个阶段:其中,预训练建立多模态生命科学表征,mid-training学习从序列到结构、功能和细胞表型的跨层规律,后训练重点增强长程推理能力。
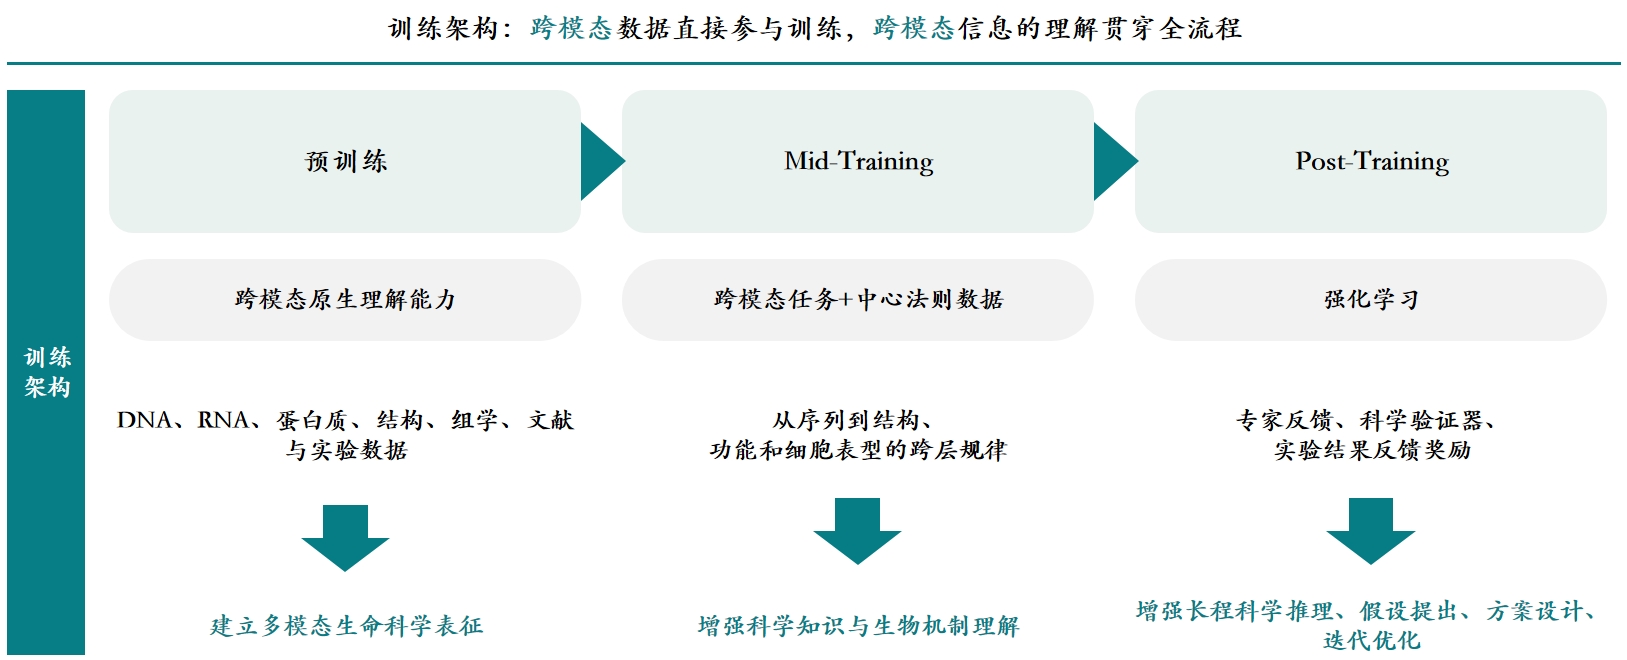
AI4S基模训练框架(图源:科理新序)
暗涌Waves:这种长程推理,跟既往垂直小模型解决单点任务,有什么不同?
张载熙:比如做酶设计,不再一步出结果,而是像人类科学家一样分步推理:先搭建酶的活性中心,它决定催化功能的核心区域;再搭建蛋白质支架,把活性中心撑起来;最后补充侧链、微调细节。
这套长链条推理能力,是传统垂直模型、工具调用智能体不具备的。
暗涌Waves:把各类科学信息转换成“大一统”的Science Token,听起来更性感,但小分子、核酸、蛋白质等数据结构差异很大,为什么你们团队可以做?
张载熙:Science Token首先要解决的,是让模型读懂不同科学模态。
过去,围绕小分子、核酸、蛋白质、复合物和跨模态文本,我们分别做过相应的基座模型。从数据收集、模型搭建到训练,完整地走过。因此,团队知道每类科学数据应该怎样编码,不同模态之间又该如何对齐。
同时,做Stella、BioClaw等智能体时,我们积累了大量长链条推理数据,也摸索了通过后训练增强推理能力的方法。
另外,干湿闭环也很重要。Stella除了计算和算法模块,也接入了自动化湿实验。我们在靶点发现、抗体优化、小核酸设计等任务中,跑通过干湿闭环案例。因此,也清楚AI 应如何对接真实科研任务、连接自动化实验设备。
模型进化,需要主动获得大量高质量数据。干湿实验闭环,可以支撑我们持续获取训练数据、持续迭代。
暗涌Waves:从目前的探索结果来看,这个基座模型的能力如何?
张载熙:在蛋白质结构预测、蛋白功能注释、RNA二级结构预测、DNA突变预测等单项任务上,已取得不错效果。
我们对这个结果不是很惊讶,毕竟科学系统本身就是复杂多模态体系,如果能把多模态信息全部纳入模型,从全局视角做设计搜索,自然更容易得到更优解。
目前,我们在探索下一代模型训练方式,比如尝试AI for AI,Recursive的训练范式,挖掘科学内在规律、拓展更多模态,或提升模型参数量,以此强化长程科学推理能力。我们期待沿着这个方向,能实现AI4S基座模型的ChatGPT时刻。
以Science Token为商业模式
暗涌Waves:从定价和商业化上看,Science Token会带来新的商业模式吗?
张载熙:是的。不过,Science Token和文本Token的定价逻辑不一样,后者定价主要参考算力和电费成本,但Science Token除了考虑这些基础成本之外,还要衡量它背后的科学价值。有些领域,比如小核酸,数据非常稀缺,对应的Token价值自然更高,定价要体现实际的业务价值。
我们希望成为AI4S领域对标
暗涌Waves:用Science Token计费,理想的买方是谁、具体用在什么场景?
张载熙:比如药企。当模型能力足够强之后,我们不需要花大力气做BD,绑定单条管线做交付。抗体管线、多肽管线、小核酸管线,各类任务都可以承接。
这时候计价单元就可以基于“消耗了多少Science Token解决这个药物设计问题”。就像Coding,不会按代码行数或模块来定价,客户信任模型能力,直接调用服务,消耗多少Token就付多少费用。这能省去大量BD个案的谈判工作。
暗涌Waves:如果这个模式能实现,它也会成为AI4S基座模型企业通行的商业化路径吗?
张载熙:Science Token还是我们提出的独有概念;至于衡量长链条科学推理数据质量的标准,及其计费标准,在全行业都没有成熟方案。我们和一些AI大厂交流时,他们也没太想清楚这件事。所以它还是一个非常早期的商业想法,需要行业共同推动形成共识。
暗涌Waves:从一级市场视角,我们能看到不少投资机构和资金在涌入,但这个方向目前的融资声量跟大模型、具身相比,还差得很远。你觉得大家的分歧在哪里?
张载熙:市场上存在两种极端心态,都可能造成投资决策犹豫。
一部分投资人认可AI4S万亿市场,相信AI科学平权,希望每个人都能释放想象力参与科学探索,他们的怀疑点在于:现阶段的技术能力,能不能把这件事做成。另一部分人则把AI4S市场看得比较小,觉得客户只有高校师生和PI,付费能力弱。
既往,市场对垂直模型具备清晰认知,但投资人对“大一统”的科学基座模型评判标准更严苛。因为他们觉得Harness加垂直领域小模型,足够解决科研需求。从用户端,很多科研人员虽向往更智能化的基座模型,但受惯性影响,习惯了调用工具化专项模型,这也是个矛盾点。
暗涌Waves:怎样的投资机构更愿意押注于AI4S基座模型?
张载熙:一些投科技的市场化基金,及部分曾深耕过制药领域的投资人。他们理解现有研发体系里的“历史技术债”,就像“屎山代码”一样:药企内部集成上百个小模型,每个环节信息传递都有损耗,维护成本极高。
因此,他们从系统工程的逻辑判断,AI会是变革这些的最强力量。这类投资人更愿意押注基座模型路线。
投资人的共识性要求是:必须快速迭代模型,抢占领头羊位置。团队配置上,我们已经把过去学术界和部分工业界大厂做AI4S基模研发的核心人才聚过来了,技术积累比较扎实。我们本来希望在今、明两年能达成一些商业化订单,但投资人觉得,短期内不需要过度在意这点,优先把模型能力做出来更重要。
















