刚刚,性价比之王Sonnet 5.5发布
果然,Sonnet 5.5真来了!
就在OpenAI年度开发者大会开幕前一天,Anthropic连夜甩出王炸——Claude Sonnet 5.5。
作为Opus 5.5的最佳搭档,Sonnet 5.5的使命是:成为最快、最省钱、最懂你日常工作的「全能打工助手」。
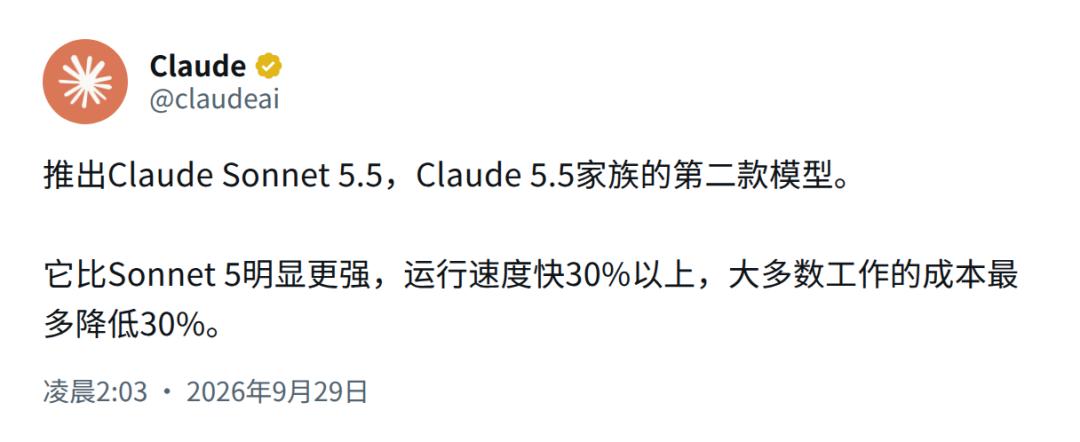
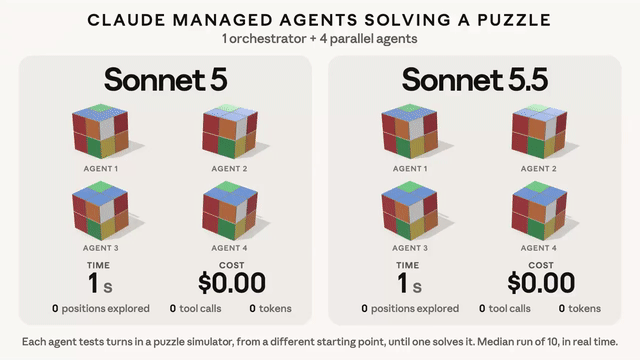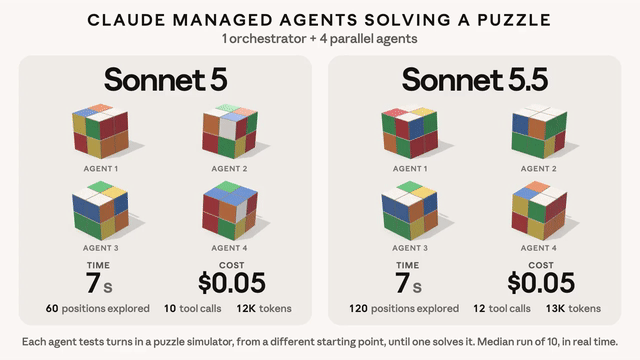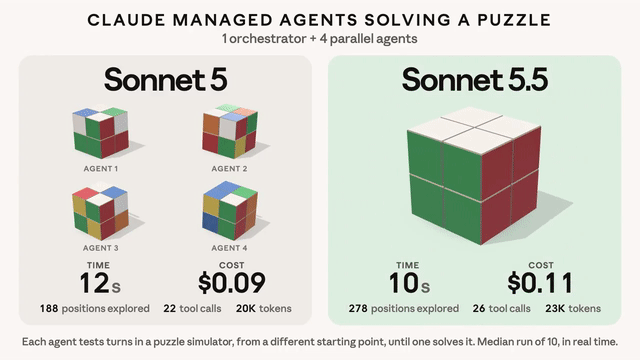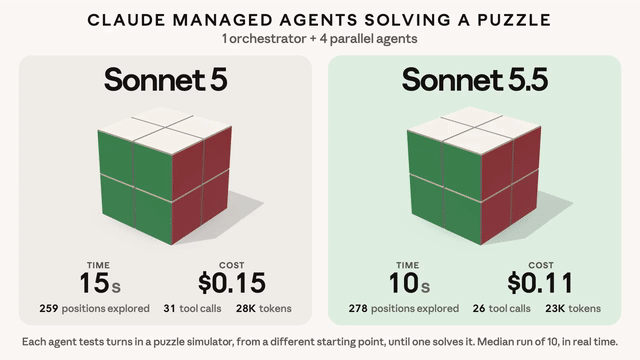
相较于Sonnet 5,它的运行速度快30%,完成相同任务的成本最高暴降30%。
另外,它的标价只有大杯Opus 5.5的一半,性能却几乎追平。
它不仅代码写得飞起,甚至成了史上第一个仅靠看屏幕截图,就能通关《宝可梦 红》的Sonnet模型。
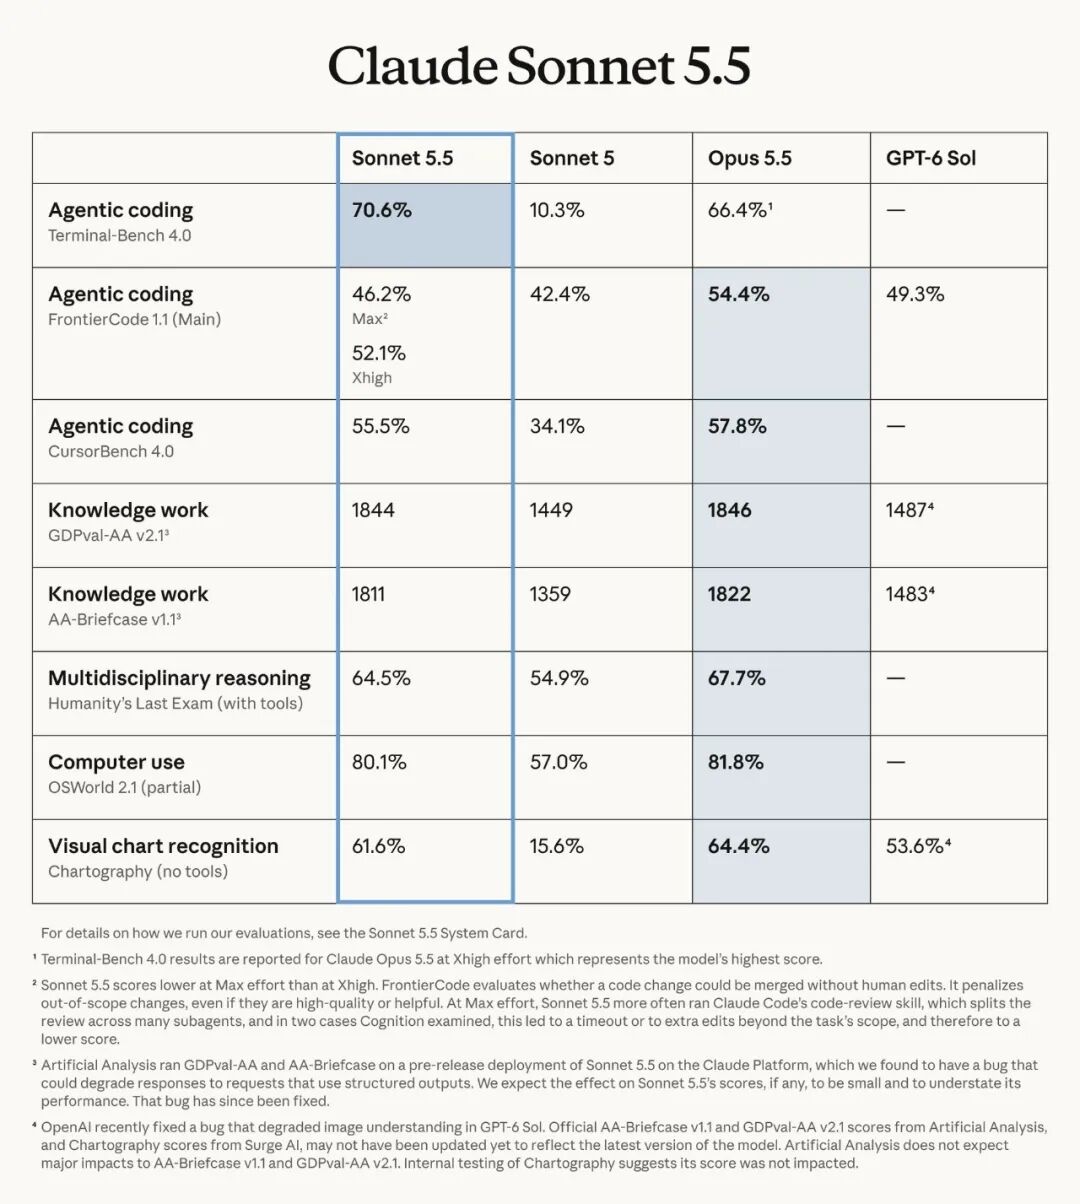
更狠的是,在极其硬核的智能体编程测试Terminal-Bench 4.0里,这个中杯,竟然把大杯给反杀了!
Sonnet 5.5得分高达70.6%,差不多是原来的7倍,比Opus 5.5的66.4%还高出一截。
一代之间,它从垫底直接冲到了自家第一。
上线没多久,第三方权威评测机构Artificial Analysis的智能指数榜直接被屠了:前三名,全被Claude家包圆,Sonnet 5.5排在第二。
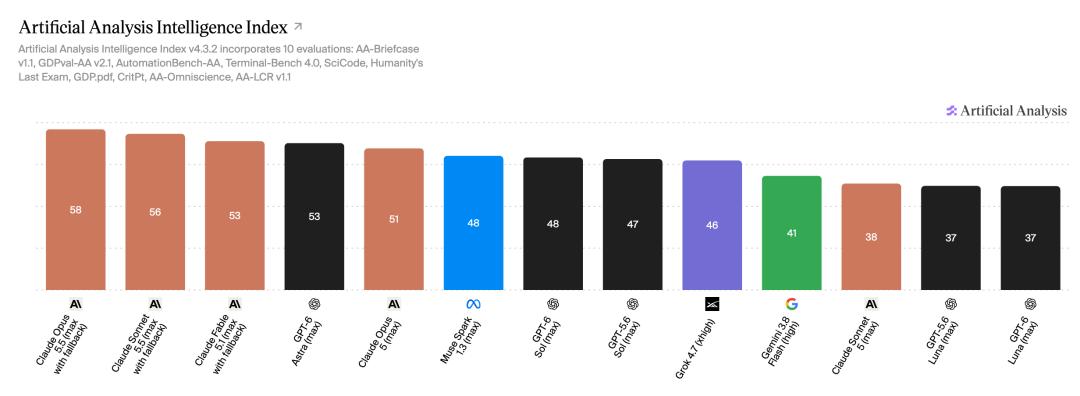
而第三名、A社四周前才端出来的超大杯Fable 5.1,标价是Sonnet 5.5的整整5倍!
短短一个月里,大杯级别的Claude,直接变身白菜价,按中杯卖了。
而且,用户可以随意调节「Effort Level」。
选低/中等:Claude 答得飞快,耗费 Token 极少,适合日常摸鱼和常规任务。
选高/最大:Claude 会进入思考模式,反复检查自己的工作,用于死磕复杂难题。
Sonnet 5.5,打破「不可能三角」
这次,Sonnet 5.5的发布,直接打破了「速度快、成本低、质量高」的不可能三角。
输出速度比前代提升了超过30%,让它毫无争议地成为迄今为速度最快的Sonnet模型。
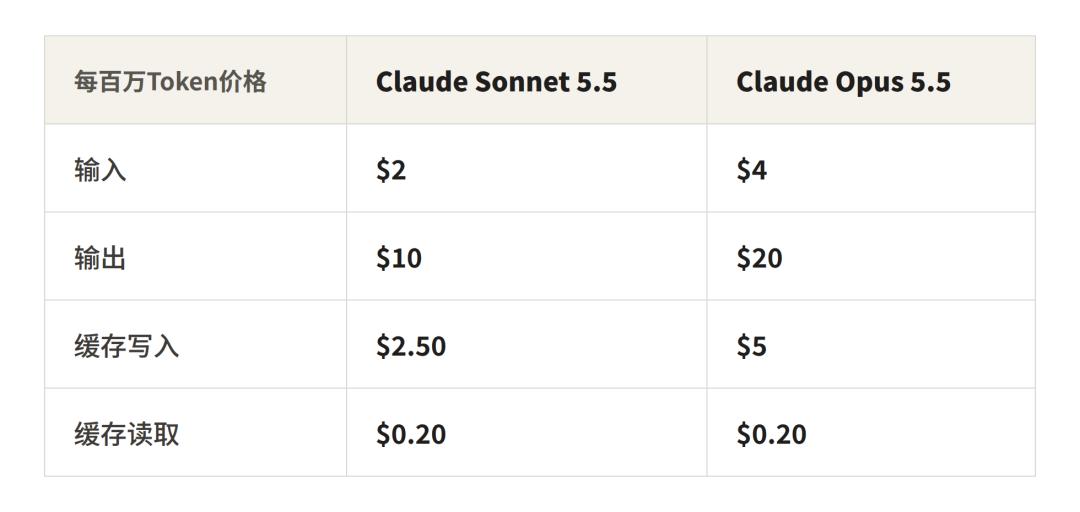
Sonnet 5.5的定价表面上和Sonnet 5一样:每百万输入Token 2美元,每百万输出Token 10美元,缓存读取每百万Token 0.20美元。
但套路藏在效率里!
Anthropic发现,由于模型变聪明了,Sonnet 5.5需要的Token大幅减少,每个任务的实际成本最多降低了30%。
用更少的Token,就能办更大的事。
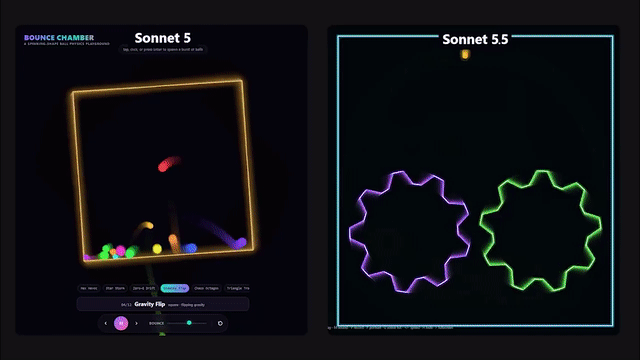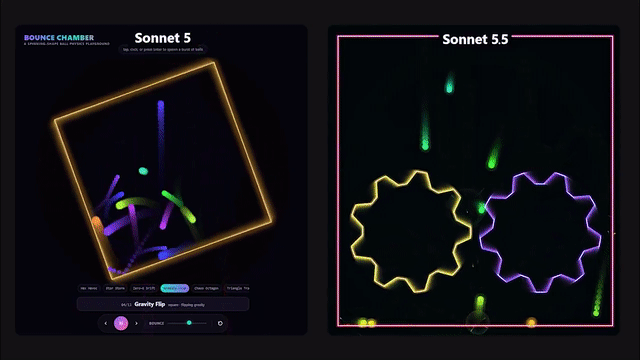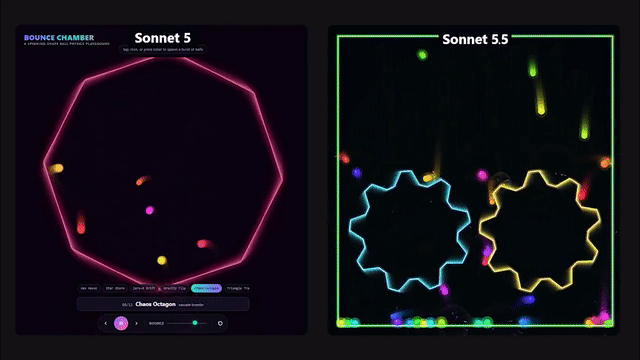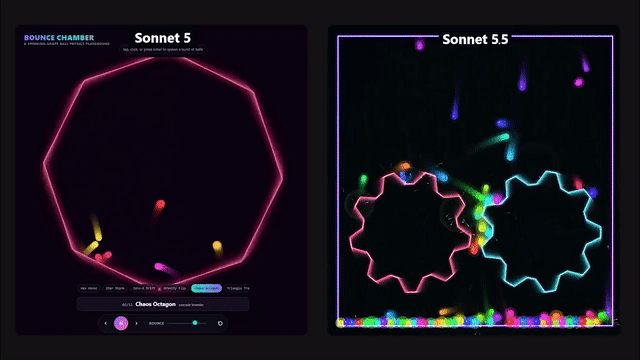
以下,是同一个prompt下,Sonnet 5和Sonnet 5.5的结果,对比非常鲜明。
半价追平Opus,自家顶配也被反超
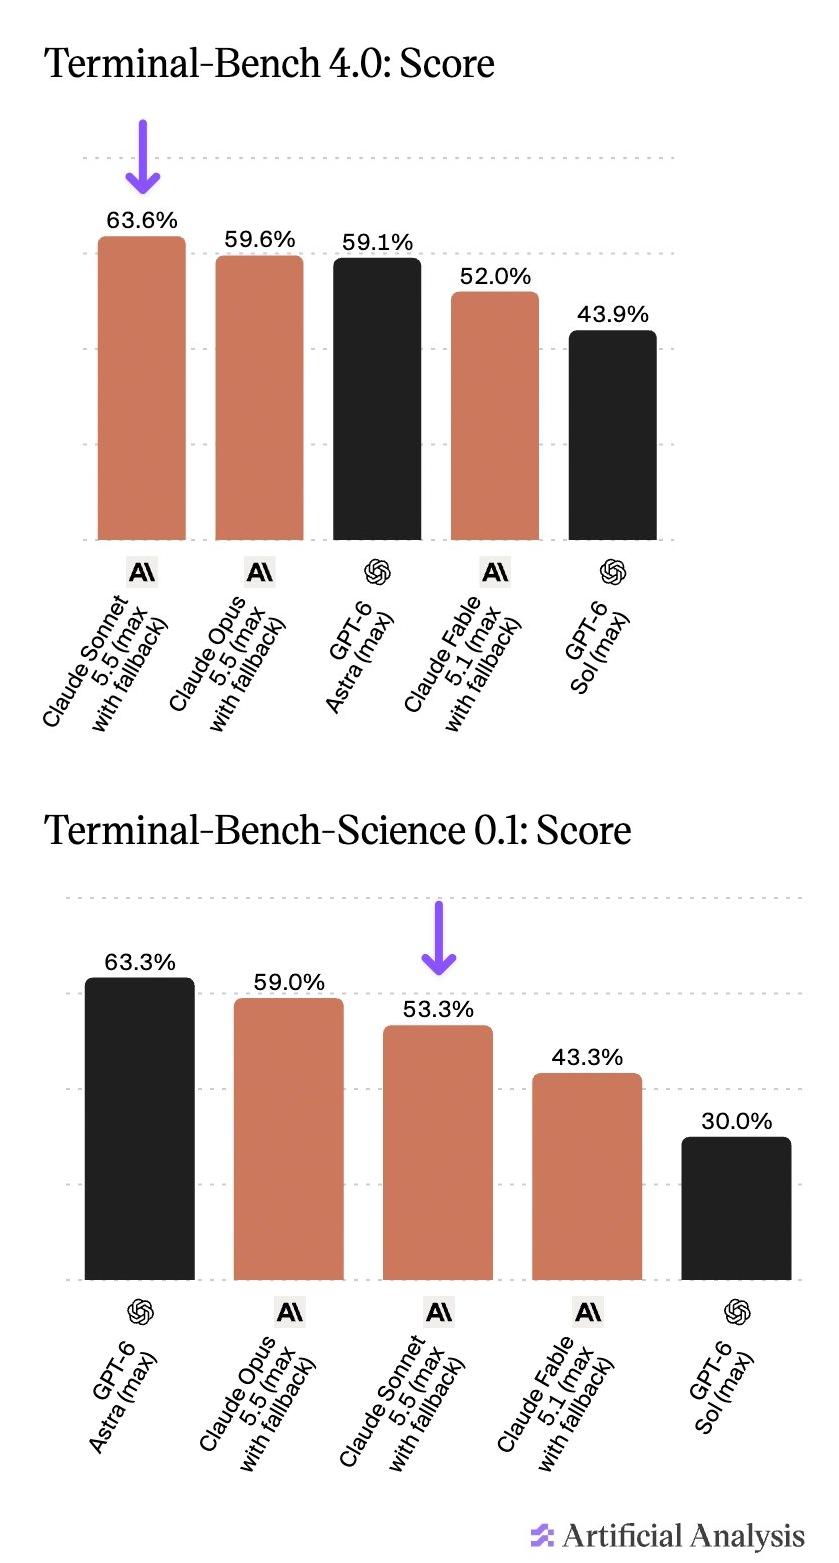
Artificial Analysis榜单上,Sonnet 5.5拿到64%,高于Opus 5.5和GPT-6 Astra的60%。
在Terminal-Bench-Science上,它拿到53%,排第三,只输给GPT-6 Astra和Opus 5.5。
写代码的另外两项测试,同样杀疯了。
在FrontierCode测试上,Sonnet 5.5最高拿到52.1%,顺手超过了OpenAI的GPT-6 Sol(49.3%)。
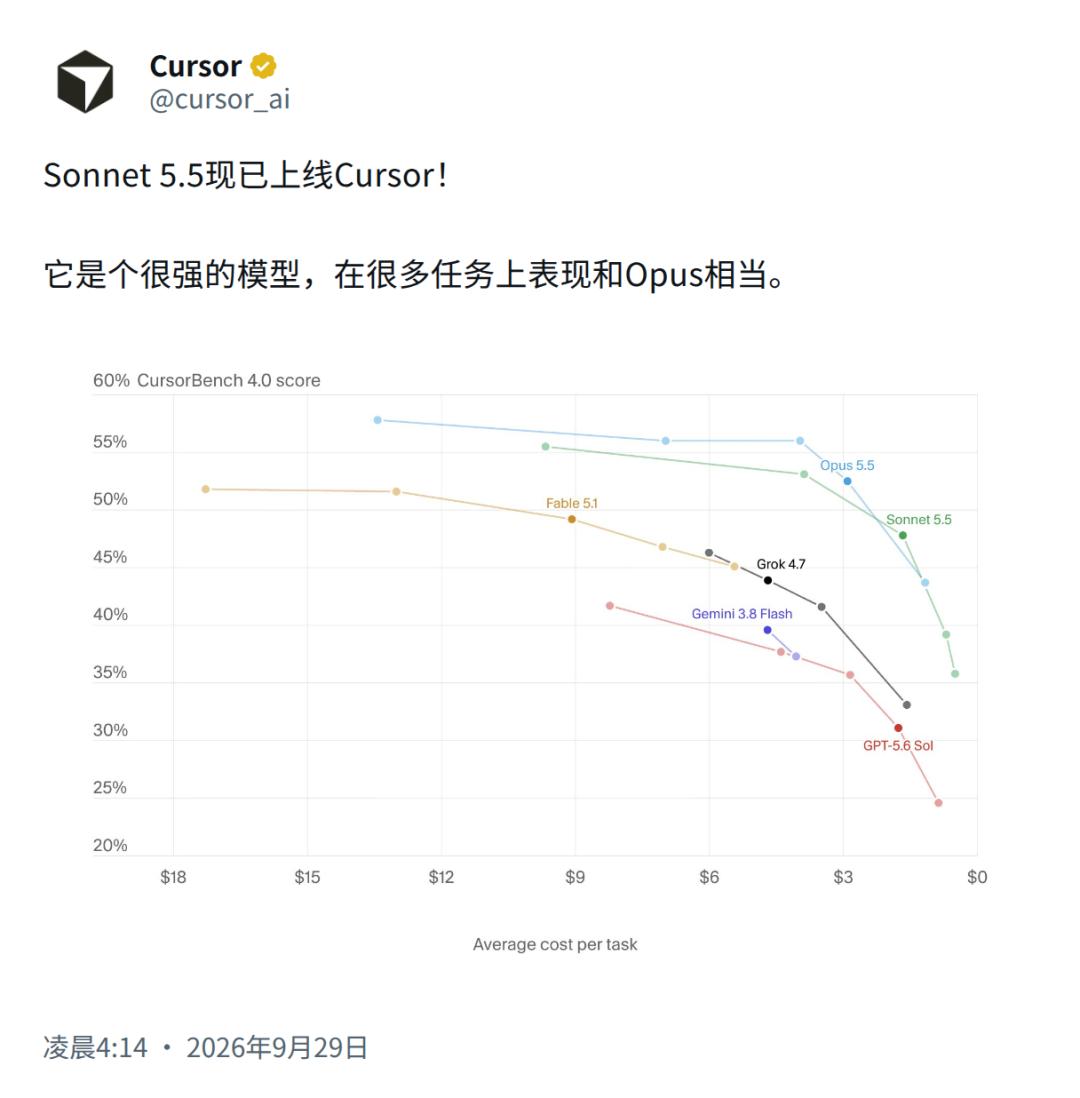
在模拟真实 Cursor 编程会话的CursorBench上,Sonnet 5.5拿到55.5%,只比大杯低2个多点,而上一代只有34.1%。
早期内测的开发者表示:「它理解庞大代码库的速度快得令人发指!」
它的工具调用效率也很惊人:在背靠背的测试中,Sonnet 5.5 学会了将工具调用「打包」批量处理,步骤更少、报错更少、花钱也更少。
不光写代码,办公能力也追平了。
GDPval-AA测的是模型在44种职业里直接交付成品的能力。Sonnet 5.5拿下1844分,大杯Opus 5.5是1846分。
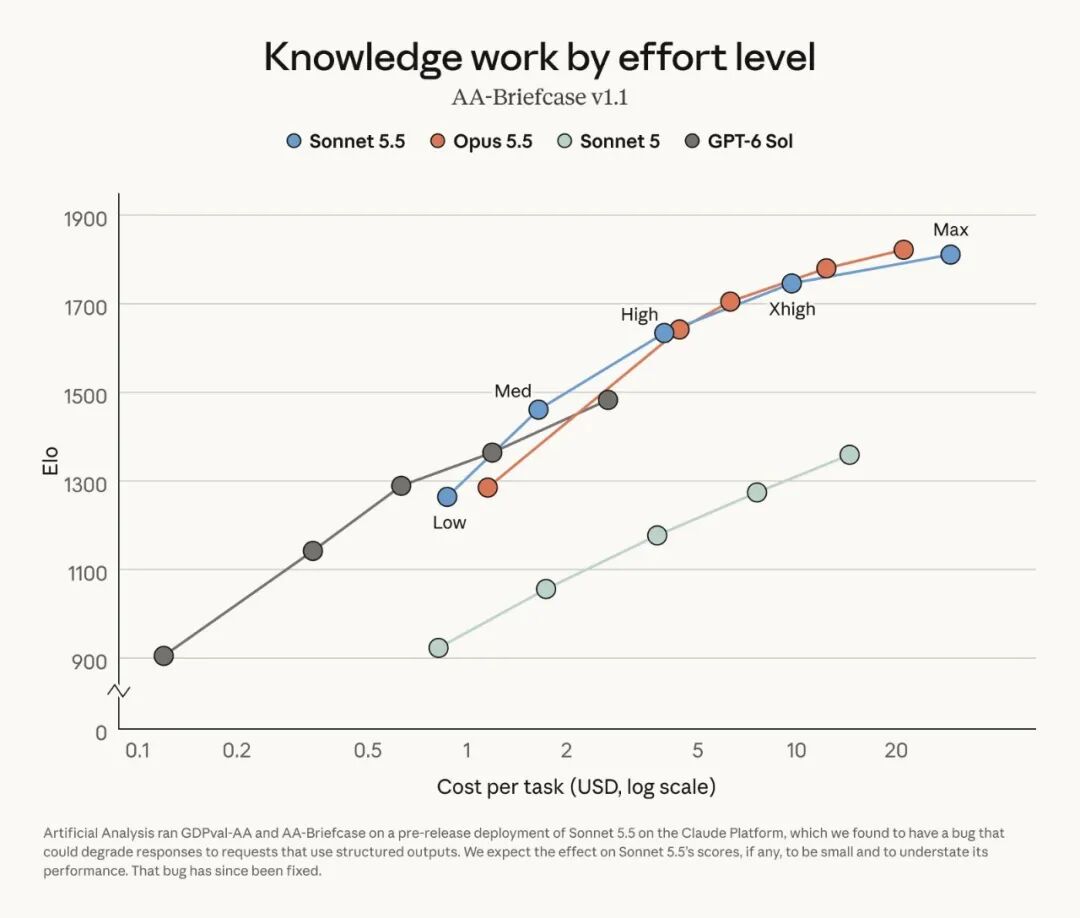
考长程知识工作的AA-Briefcase测试里,Sonnet 5.5拿到1811分,和Opus 5.5的1822分几乎打平,比GPT-6 Sol高出300多分。
最让人惊喜的,是它展现出的「设计天赋」。
这次,Sonnet 5.5 懂审美了!它能主动美化UI,甚至能完美遵循幻灯片模板,生成几乎不需要人类修改的 PPT。
Anthropic内部有个硬核的案例:测试人员扔给 Sonnet 5.5 一家上市公司的季度财报资料、电话会议记录,以及一个 PPT 模板,要求它生成一份 10 页的运营审查幻灯片。
结果,它生成的初稿被两位人类专家鉴定为:「完美,可直接发送。」
在带工具的「人类最后的考试」上,它拿到64.5%,比上一代高了将近10个点。
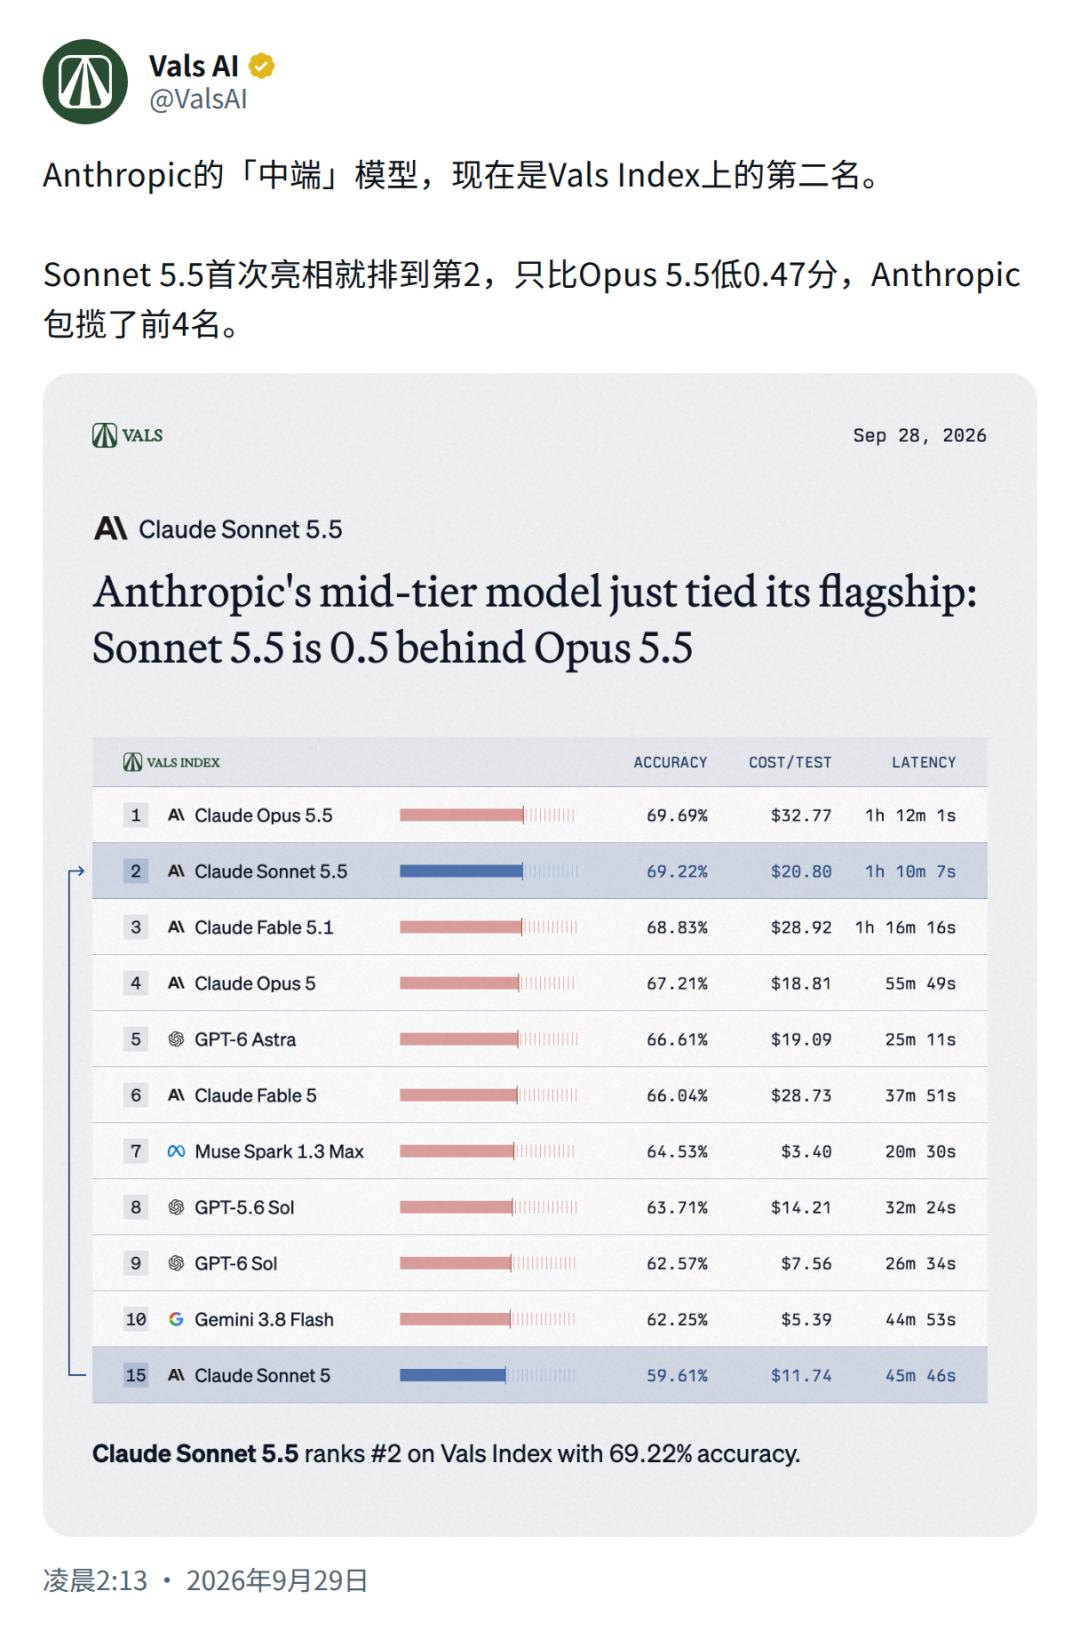
另一个第三方榜单Vals Index上,Sonnet 5.5首次上榜就排到第二,只比Opus 5.5低0.47分。
四周前,Fable 5.1刚发布时,还是全球最强的编程和知识工作模型。
现在,Sonnet 5.5在Terminal-Bench 4.0上比它高出将近15个点,GDPval-AA高出109分,智能指数也高出3分。
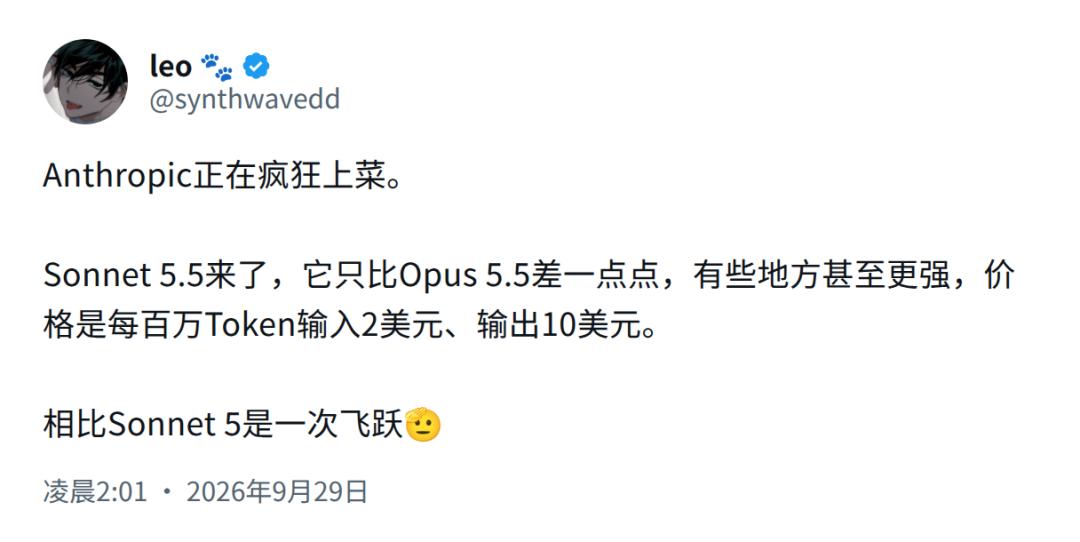
科技博主@synthwavedd在发布当天发帖说,Anthropic正在疯狂上菜。
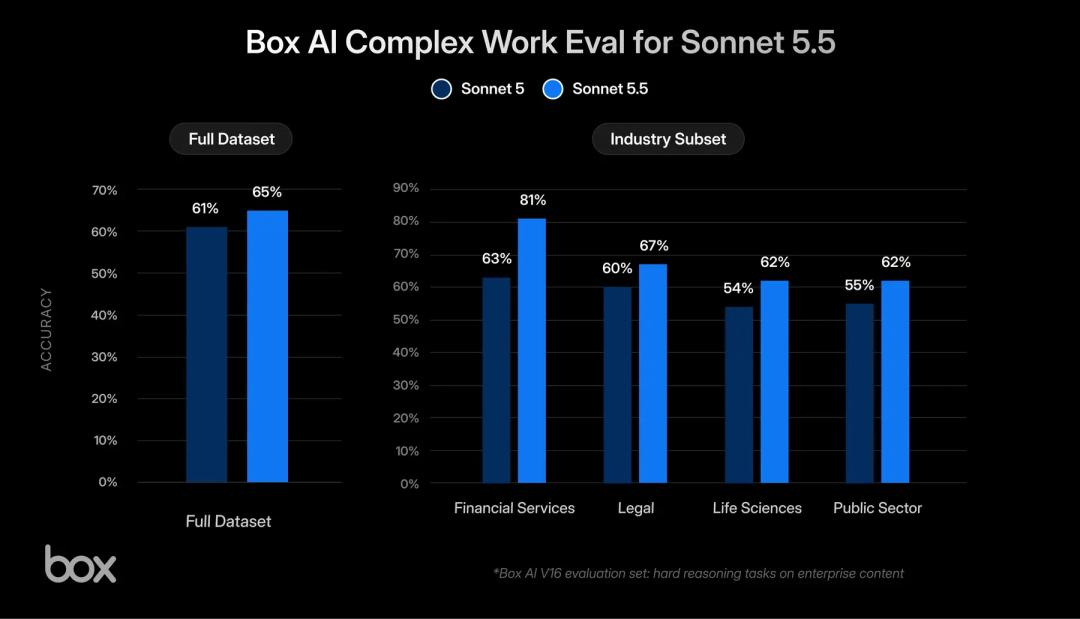
在复杂办公测试Box中,Sonnet 5.5 的整体准确率达到 65%,而 Sonnet 5 为 61%。
它完成交付成果的速度也快了约 2.4 倍,总 token 消耗量还降低了 12%。在智能体工作中,速度和准确性通常会相互拉扯,所以一个能同时兼顾两者的模型确实是实实在在的进步。
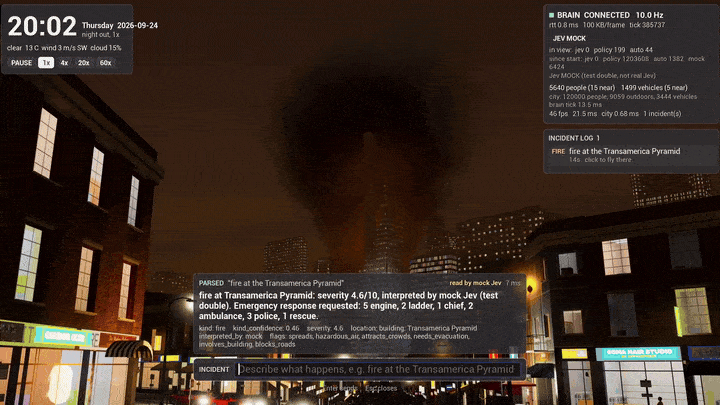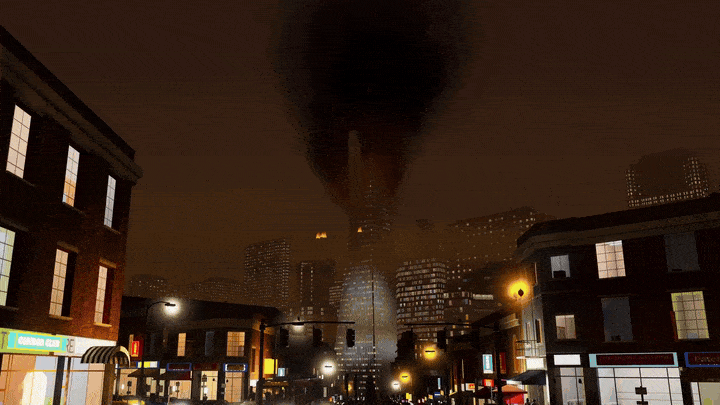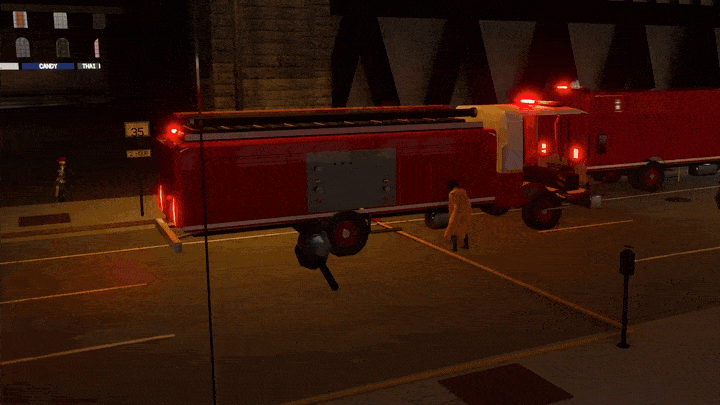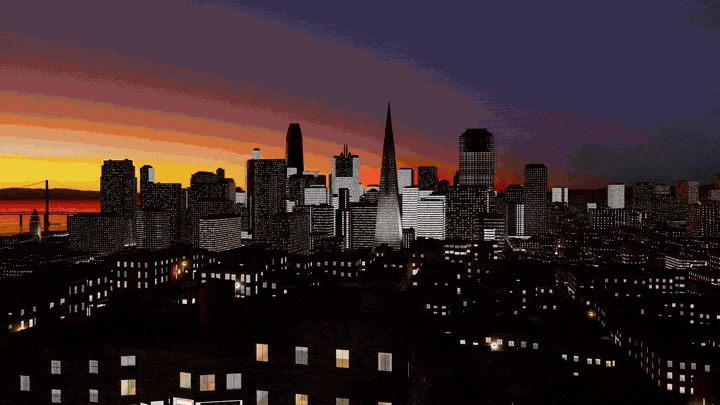
它搭的旧金山,着火了会自己派消防车
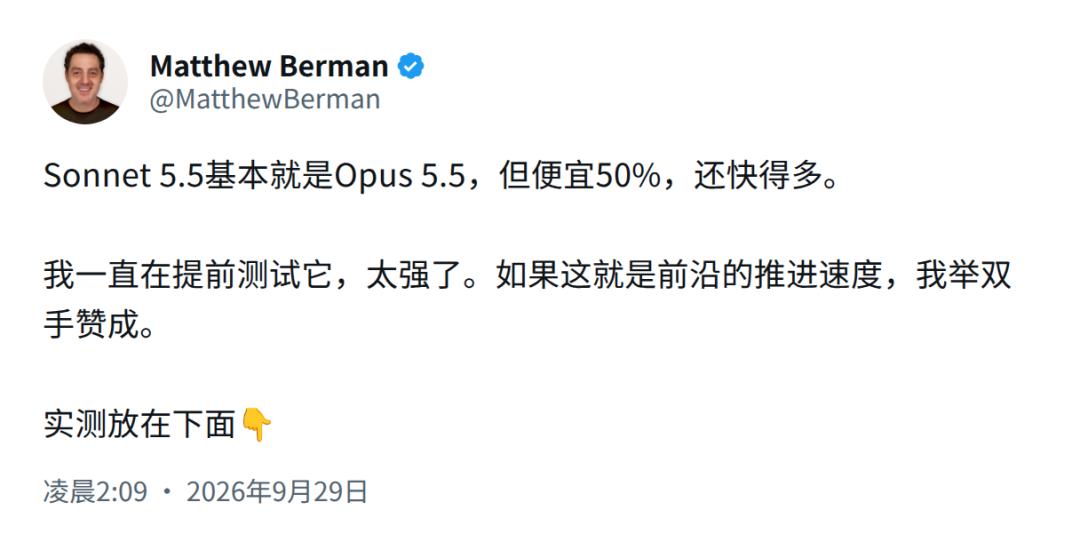
实测显示,Sonnet 5.5强得离谱。
AI博主Matthew Berman拿到了Sonnet 5.5的提前测试资格,发布当天一口气放出了一串实测。
他让Sonnet 5.5在虚幻引擎里现场手搭了一座旧金山。街道上车流不息,甚至还有骑自行车的人穿过路口。
输入一句「泛美金字塔起火」,系统立刻把火情评为4.6级(满分10级),随即自主派出5辆消防车和3辆警车。
远处的大楼冒起滚滚黑烟,警车闪着灯赶到路口,当场拉起警戒线。
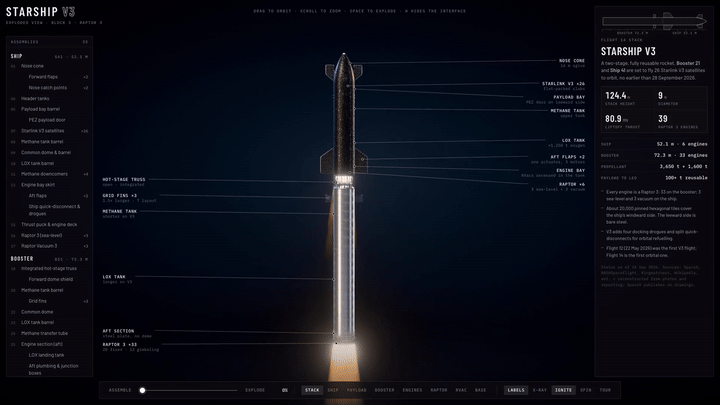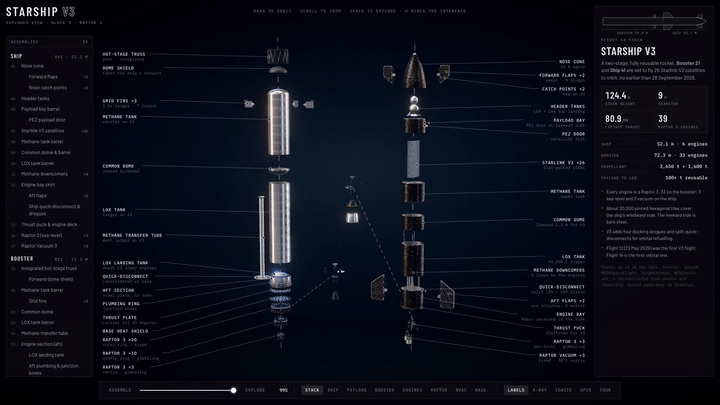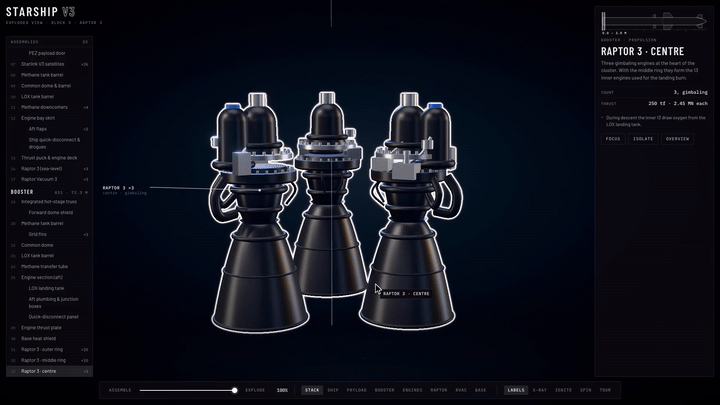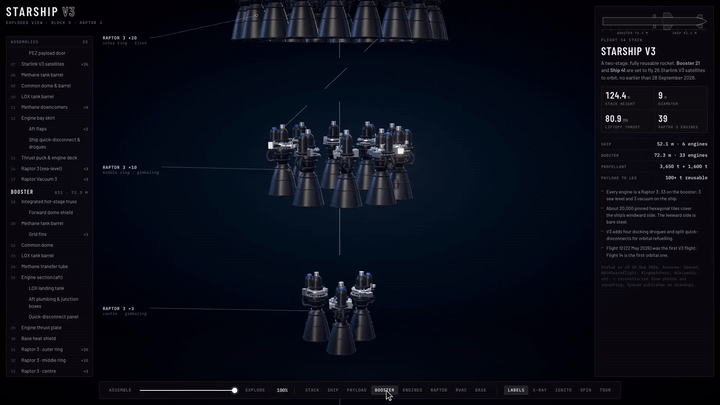
甚至连星舰V3,都被它做成了可交互的爆炸图。整艘飞船一层层拆开,一直拆到底部的猛禽3发动机。
他还用Claude Sonnet生成了在线乐高游戏。
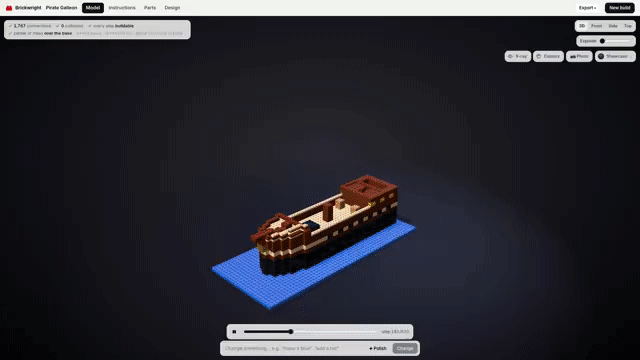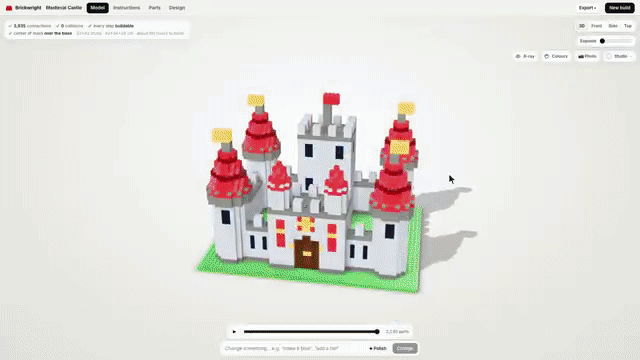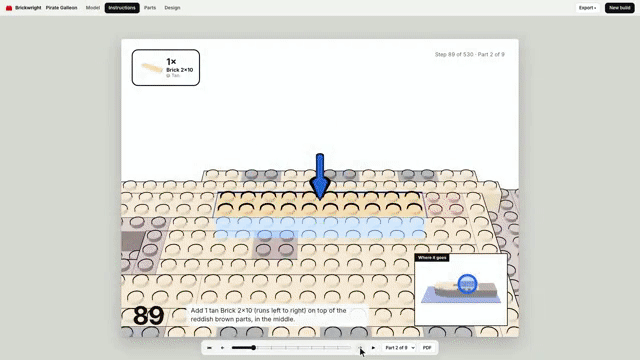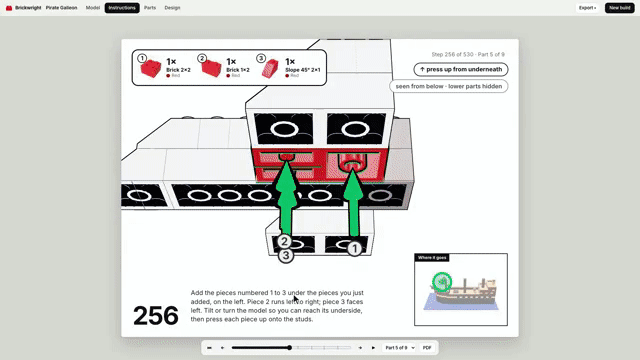
Matthew Berman感慨3D 模拟已被Claude攻克。
但也有人表示了不同意见。
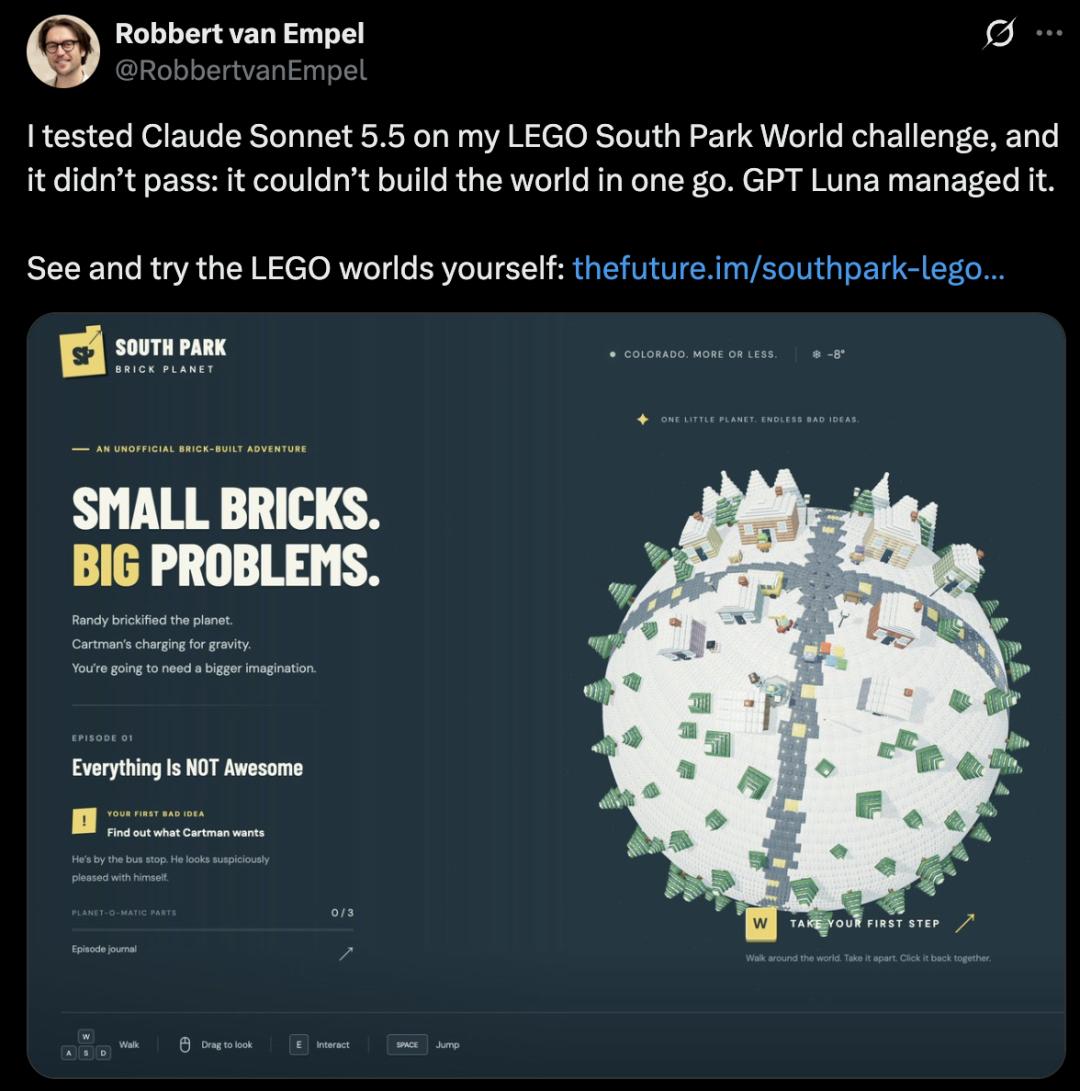
Robbert van Empel维护了一个LEGO积木星球挑战,要创建一个带有《南方公园》剧情的可互动游戏:
Create a 3D world as a globe with a South Park theme. I want to be able to walk through the world using WSAD, interact via 'e', and jump using the spacebar. I also want to be able to rotate the mouse and move objects. I want the world to be made of Lego bricks. Also, make it a game where the characters make typical South Park jokes, and the game must really have a South Park storyline.
Claude Sonnet 5.5这次被测试了,但它没能通过:它无法一次性构建出整个世界。而GPT Luna 则成功做到了。
另一个卖点,就是快。
同一个题目,让两代模型并排写一段鸟群模拟代码。Sonnet 5.5写完代码、鸟群已经飞了9秒,上一代还在一行行往外蹦代码。
困住Claude一年多的宝可梦,这回只看截图就通关
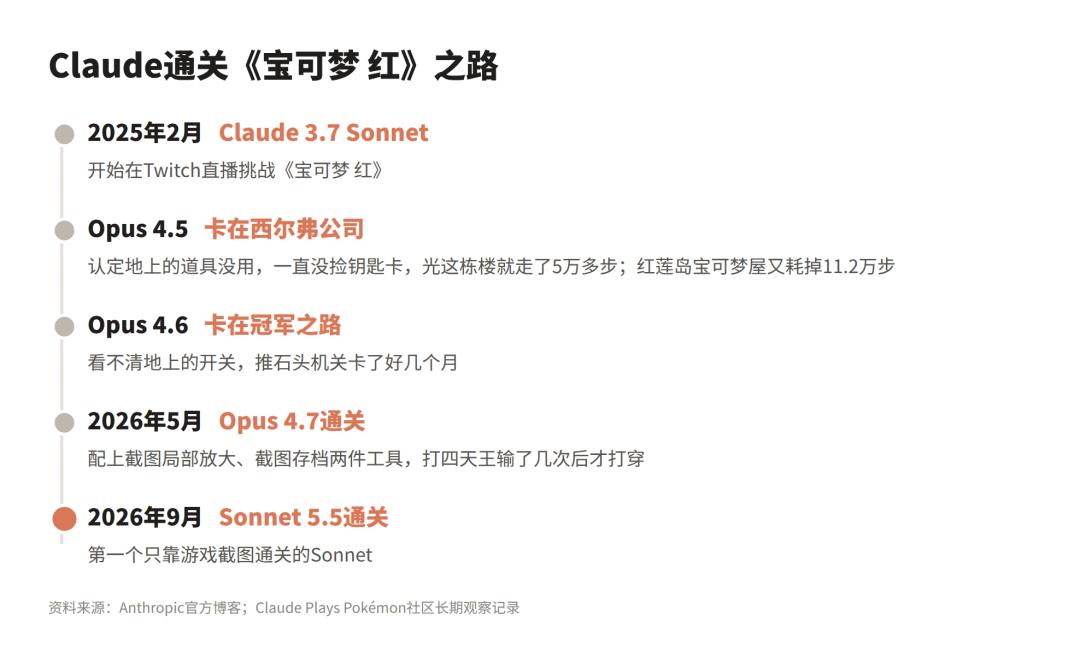
Sonnet 5.5也破了纪录,成为第一个只看游戏截图,就通关《宝可梦 红》的中杯模型。
此前,Claude已经和宝可梦死磕一年多了。
2025年2月,A社就开始让Claude玩《宝可梦 红》,每一代都被不同关口卡住。
Opus 4.5在一栋楼里困了好几周,硬是不去捡关键的钥匙卡;Opus 4.6一路打到接近冠军,结果被某个机关卡了几个月,因为看不清地上的开关在哪。
直到今年5月,Opus 4.7才终于通关,凭着两个外挂:一件能放大截图,一件能把截图存成记忆。
四个月后,Sonnet 5.5只靠看截图,就一次性通关了!
关键原因,就是它「长出」了眼睛。
在不借助工具强读复杂图表的Chartography测试里,它从上一代的15.6%暴涨到61.6%,翻了近4倍。
在看着屏幕截图去操作电脑的OSWorld 2.1测试里,它涨到了80.1%,和Opus 5.5的81.8%仅差1.7个点。
这刺激到了网友Goody,要Sonnt5.5开发了一款属于他自己的游戏。
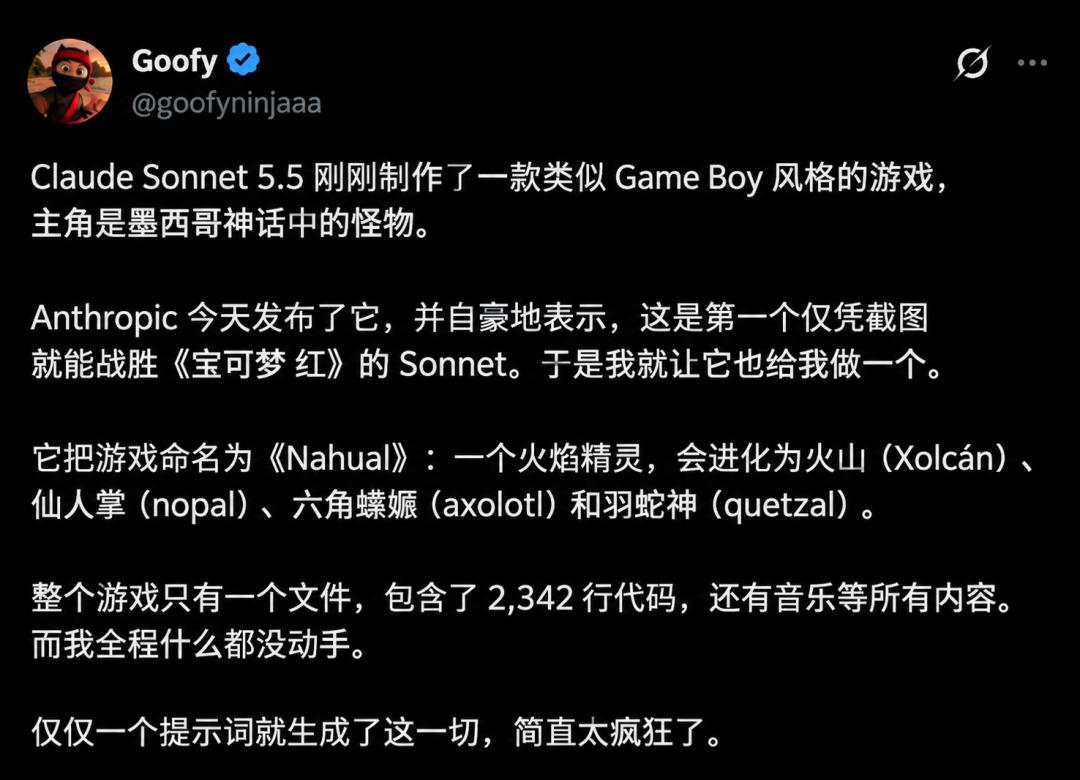
这是一款墨西哥怪物风格的 Game Boy 游戏。
Sonnet 5.5把它命名为《Nahual》:一只火属性的墨西哥无毛犬,可以进化成 Xolcán、一株仙人掌、一只美西螈、一只凤尾绿咬鹃。
单个文件 2342 行代码,连音乐都有。
一个提示词,Sonnet 5.5就创造出了一个新的类《宝可梦》游戏,简直疯狂至极。
档位开到最高,中杯反而比大杯还贵?
不过,Sonnet 5.5标价便宜,最后能不能省下钱,全看你把「努力档」开到哪一格。
努力档(effort)是Claude留给开发者调节脑力的开关,从Low到Max一共五档,档位越高越烧钱。
如上文所说,官方表示:和上一代相比,Sonnet 5.5单个任务最多便宜30%。
在很多测试里,Sonnet 5.5只开Low或Medium档,就能锤爆上一代的满档成绩,成本更是只有十分之一。
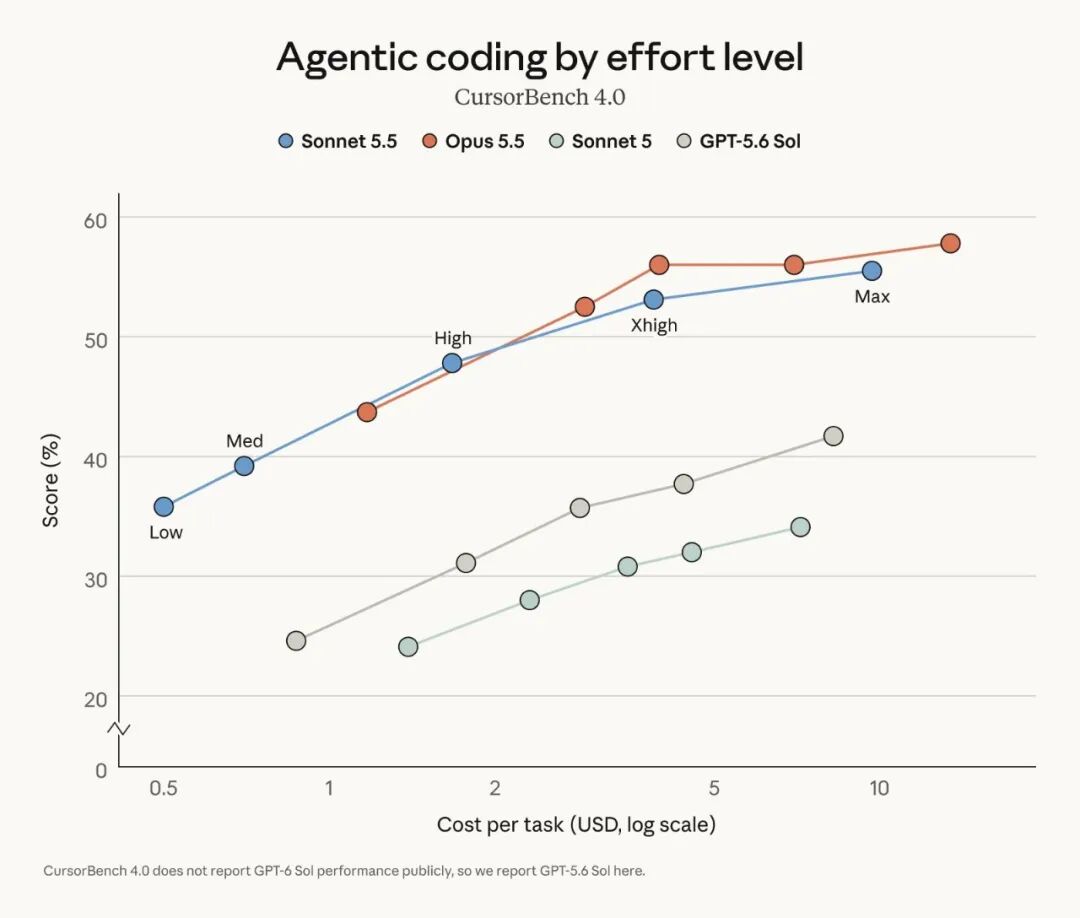
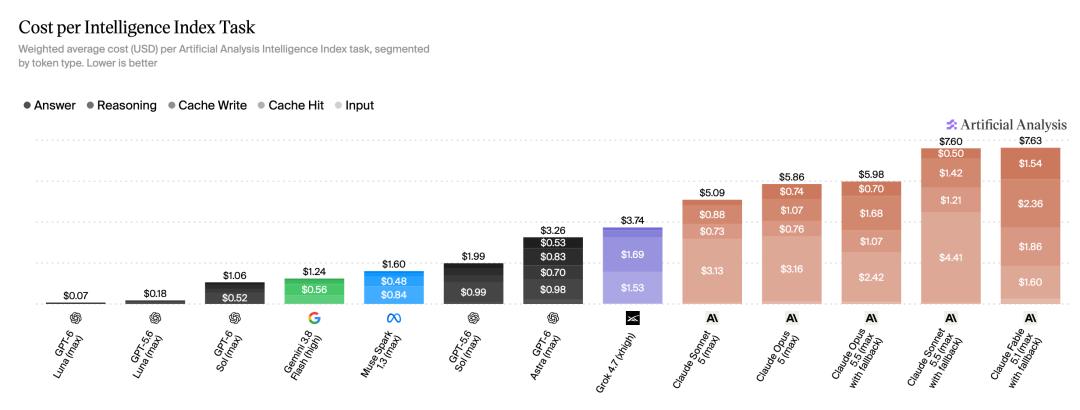
但Artificial Analysis把档位推到Max一测,结果就有点吓人了。
在Max档下,Sonnet 5.5每做一道题,平均要狂吐19.3万个输出Token!这是该机构测过的历史最高纪录。比大杯Opus 5.5的Max档多吐了六成,大约是GPT-6 Astra的7倍。
所以,哪怕单价减半,Sonnet 5.5满档跑一个任务也要花7.60美元。不仅比上一代贵了50%,甚至比大杯Opus 5.5(5.98美元)还贵,直接逼近了超大杯Fable 5.1的7.63美元!
满档甚至还会帮倒忙。
在测试代码合并的FrontierCode上,Sonnet 5.5开Max档只拿到46.2%,反而比低一档的Xhigh(52.1%)还低。
原因是满档状态下它太爱调用代码审查工具,把活儿包给一大群子智能体。结果要么跑超时,要么手欠改了任务范围之外的代码,直接被扣分。
所以真要省钱,修Bug、写文档这种日常活,Sonnet 5.5开Medium或High档最划算。复杂的长任务,直接交给大杯Opus 5.5的High档,千万别无脑把中杯开满。
护城河升级,继续防蒸馏
这次,A社一如既往采取了防蒸馏机制。
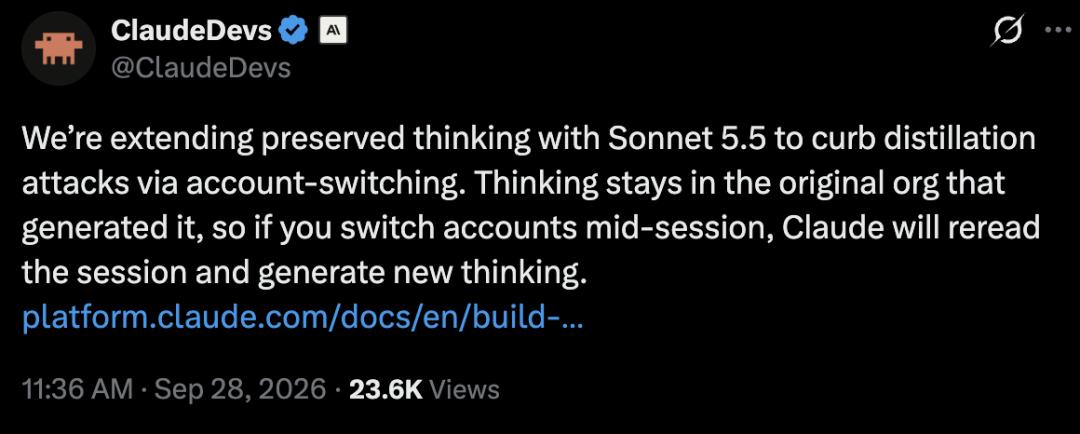
官方原话是:「由于 Sonnet 5.5 的能力远超其前代版本, 它是首款搭载安全分类器以防止推理提取的 Sonnet 模型。」
这意味着 Claude 脑子里的「思考过程」无法与账户解绑。
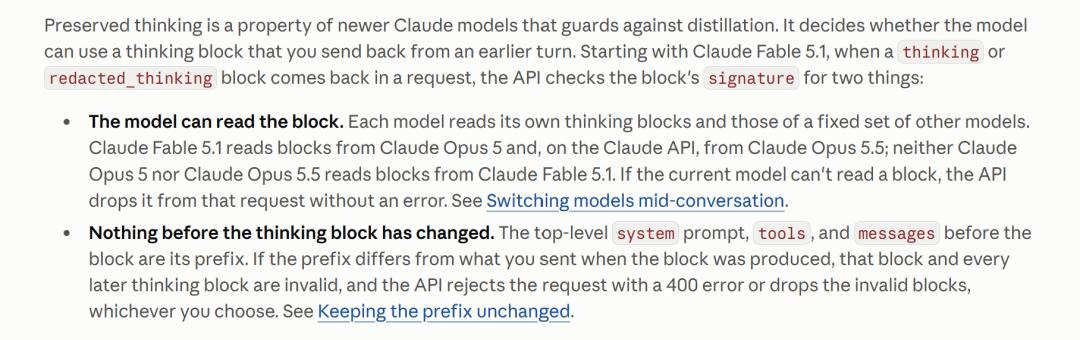
对于正经开发者来说,你完全感觉不到变化;但对于想白嫖核心技术的人来说,这条路就彻底堵住了。
而且,由于Sonnet 5.5的网安能力大升级,它也成为了第一款配备Opus同级别「网络安全防护与回退机制」的 Sonnet 模型。
遇到高风险网安任务时,系统会自动回退到Sonnet 5。
在生物学领域,它也会拦截高风险请求。
现在,压力给到OpenAI
现在,压力全在OpenAI这边了。
9月22日,Anthropic发大杯Opus 5.5,90分钟后OpenAI发了GPT-6 Sol和Luna,双方直接硬刚。
6天后,Anthropic发了中杯Sonnet 5.5。标价和GPT-6 Sol一模一样,智能指数却碾压。
OpenAI DevDay,就定在美西时间9月29日,Sonnet 5.5发布的一天后。
Claude已经把最强战力价格拉到白菜价,OpenAI要拿出什么迎战?
参考资料:
https://x.com/goofyninjaaa/status/2104657861334950098
https://x.com/AnthropicAI/status/2104633259925630995
https://x.com/claudeai/status/2104633115620823187
https://www.anthropic.com/claude-sonnet-5-5
https://blog.box.com/claude-sonnet-55-real-enterprise-knowledge-work
https://x.com/MatthewBerman/status/2104634635234005025
https://x.com/MatthewBerman/status/2104634641772925084
本文来自微信公众号“新智元”(ID:AI_era),作者:摩西 Aeneas 大卫,36氪经授权发布。
















