存力接棒算力,HBM为什么“脱颖而出”?
站在今天回望25年下半年,可以说是AI硬件产业链一个非常关键的拐点,在此之前以英伟达GPU为代表的“算力”站在AI硬件的舞台中央。在此时点之后,包括内存(DRAM)、闪存(NAND)和硬盘(HDD)在内的“存力”则接棒成为了整个产业链中最大的卡点。
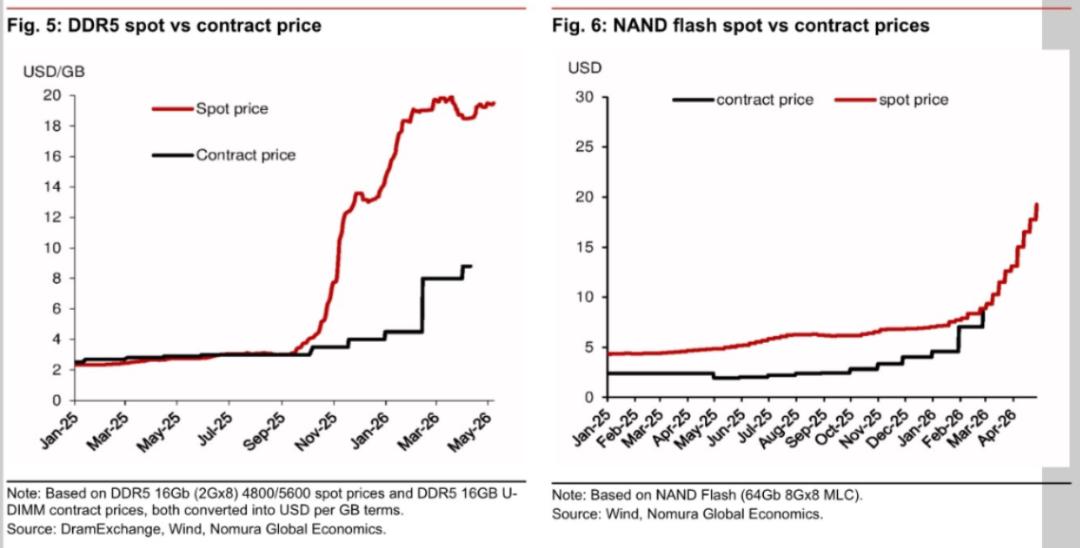
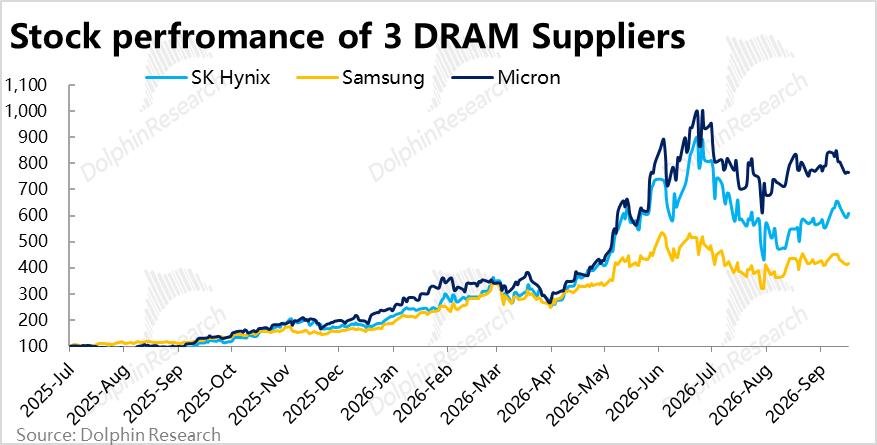
由下图可见,DDR5内存的价格自25年9月后的半年内飙涨了接近7~9x,NAND闪存的价格同期内也有4~5x的涨幅。对应的,美光和海力士两家内存龙头厂商的股价在此期间也在短短半年时间内一度有约10x的涨幅。
近期海豚君终于得以对这轮轰轰烈烈的存力周期进行研究和复盘,进而展望后续走势,进行一个大的主题系列研究。前几天我们已经以闪迪为对象,初步探讨NAND闪存的情况(可见链接)。
本篇我们就开启对更稀缺的高性能内存HBM的探讨,作为首篇,我们将从底层技术的角度出发,主要讨论以下几个问题:
1)为什么近一年,AI对存力的需求“突然”爆发?AI大模型对内存的核心要求是什么?
2)为什么HBM-High Bandwidth Memory,即高带宽内存成为了当前高性能GPU首选的内存规格?是什么技术让其脱颖而出?
3)HBM采用的技术,又有哪些难点和代价?对整个内存产业链和内存厂们有怎样的潜在影响?
并以此夯实理解的基础,以便在后续系列中进一步探讨后续行业的技术演进路线,不同厂家的差异之处,以及最后对投资逻辑和投资的影响。
以下是详细分析
01 “存力”何以成为最大瓶颈?
随着AI技术的演进,对内存/闪存的需求出现了爆炸式的增长,以至于“存力”一度被视为比“算力”更大的瓶颈。那么到底为什么AI对存力的需求和性能要求似乎“一夜之间”突然暴涨了?这个问题可以从两个角度看,一个是需要更多的内存容量,另一个是需要更快的数据传输速度。
更多的内存需求
概括来说,对更多内存容量的需求,主要是模型参数的走高,模型上下文规模的提升,以及Agent带来的更多工作流,这三个原因所导致的。
a. 模型参数:首先,AI大模型对内存的第一块需求,是用于存储模型的全部参数。这一部分所需内存容量的计算逻辑相对简单、近乎是和参数量线性正相关。只取决于模型的总参数量、以及存储每个参数所需的字节量。
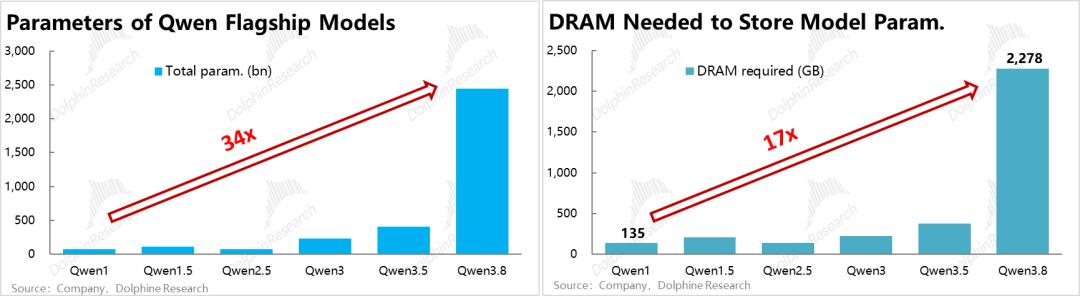
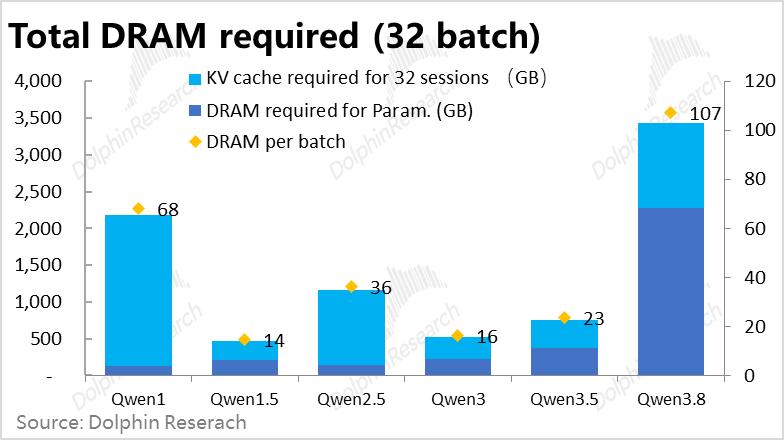
但由于大模型能力进化的需要,旗舰级模型的总参数量在过去3~4年间也有约几十倍量级的增长。以我们比较熟悉的Qwen模型为例,从第一代Qwen模型到最新的Qwen3.8 Max,总参数量从720亿增加到约2.4T,对应每个模型实例存储参数需要的内存容量就从135GB增长到近2300GB,即原先的约17x。
(注早先几代大模型参数一般以BF16精度存储,每参数需要2字节,而近期存储精度普遍为FP8或更低,每参数只需1字节或更低)。
b. 推理缓存:相比每个模型实例固定占用的参数存储部分,对内存需求更大的弹性来自于推理输出时需要存储的KV缓存。这一块内存需求的计算逻辑相对复杂、不是简单的线性增长,取决于模型的上下文长度,和模型的注意力架构对缓存压缩的效率。
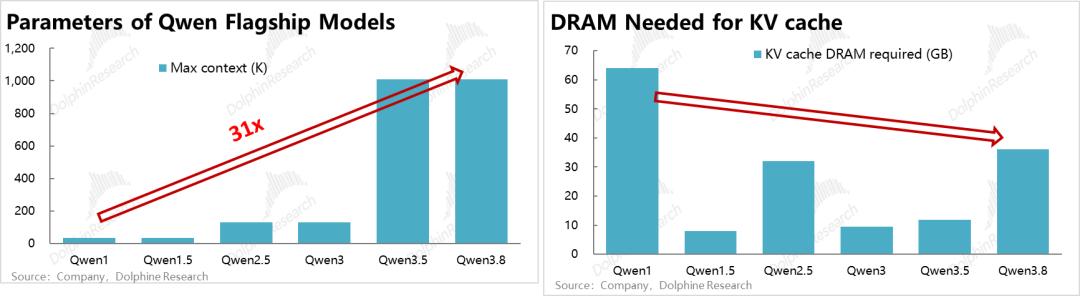
可以看到,从Qwen初代到Qwen3.8 Max,模型上下文容量也扩大了约31x,和同期内参数量增长的幅度接近。不过因缓存技术的进步,所需的内存容量的增长幅度要小得多。
根据我们的计算,Qwen3.8 Max的最大上下文长度是Qwen2.5的约8x,但前者单个会话所需的缓存容量约为36GB,只比Qwen2.5高出约12%。(以上测算都是基于使用最大上下文80%的情况下计算的)。
虽然由于软件技术的进步,新模型单会话需要的缓存容量增长的幅度远低于模型参数和上下文的提升速度,但因为AI用户数和会话数的飞快增长,所有会话缓存加起来的内存容量的总需求仍可能有数十乃至百倍的增长。
以同时处理32个会话为例(使用最大上下文的80%),Qwen3.8 Max模型实例所需的总内存量(参数+KV缓存)仍达到约2.3+1.3=3.6TB。
c. 除了以上AI大模型或Agent自身对内存的需求外,AI Agent工作时可能会产生很多传统的运算需求或操作,例如写文档、操作Excel,这都会产生对内存、闪存的需求。(当然这部分需求不需要HBM这类高规格产品)
更快的传输速度
以上是从容量需求的角度,而实际上AI计算对于数据传输速度的要求可能更加重要。这一点也能从两个角度出发,一是为了匹配计算芯片更快的计算速度、不因内存传输速度拖累整个系统的效率,另一点则是更大参数规模和更长上下文模型,推理所需的缓存数据读写需求是爆炸式增长的。
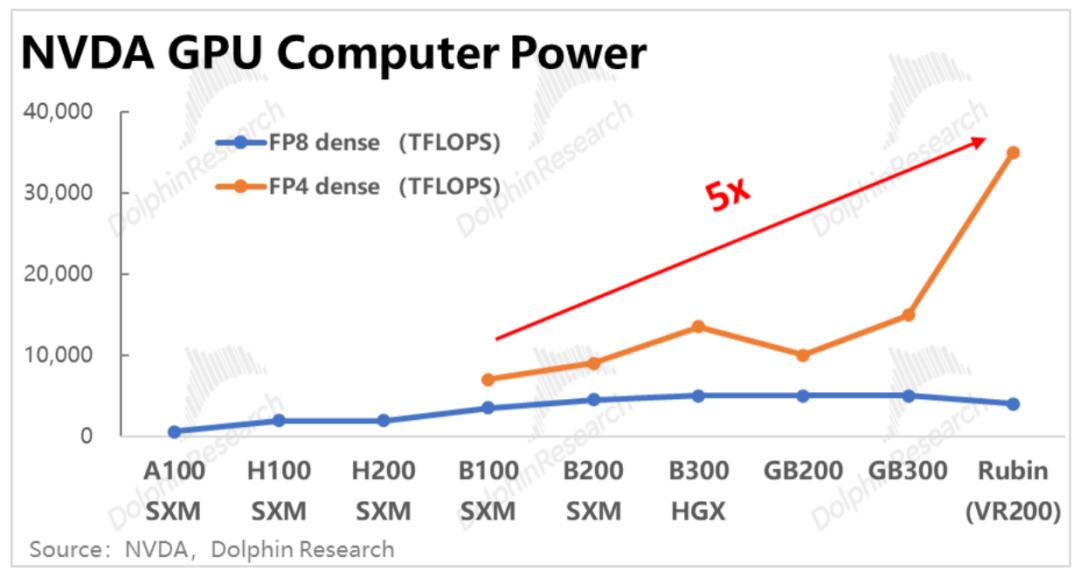
a. 更强的芯片需要更快的内存:以最通用的英伟达芯片为例,从B100到VR200的迭代中,芯片的算力已是原先的5x(基于FP4 dense精度),因此逻辑上对内存传输数据的速度(术语叫带宽)也自然会水涨船高。
简单举例来说,如果某芯片1秒能计算1GB的数据,而其内存每秒只能输送0.5GB数据,就等效于GPU将有近一半的时间被闲置来等待内存,导致芯片算力的浪费。
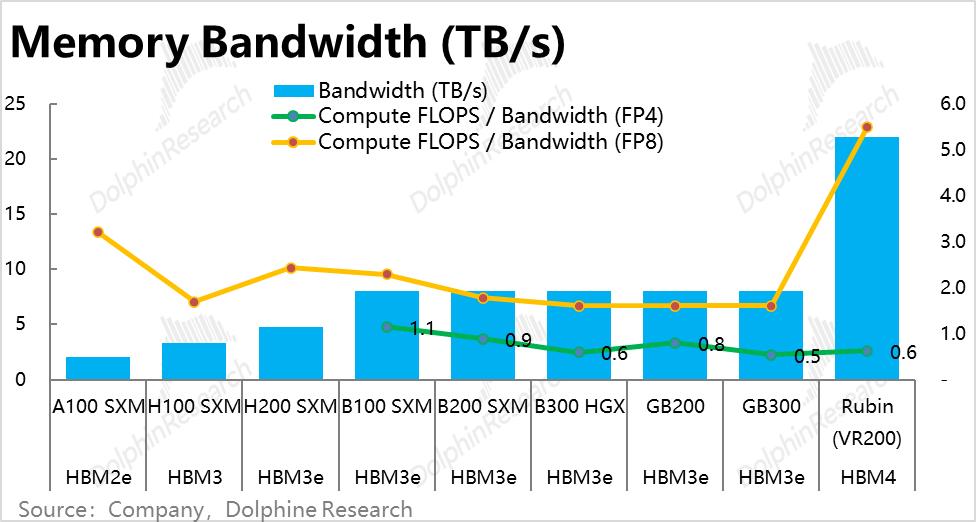
现实情况中,从B100到GB300,5代GPU使用的内存带宽一直卡在8TB/s没有增长(都是用的HBM3e),对应内存带宽/芯片算力的比值从1.1走低到0.5(基于FP4精度)。
而虽然VR200使用的新一代HBM4的带宽大幅提升到了22TB/s,但因VR200的算力同样相比上代提升了2~3倍(FP4精度),因此VR200对应带宽/算力的比值也只有0.6。因此,内存带宽依然是整个算力系统中的相对瓶颈。
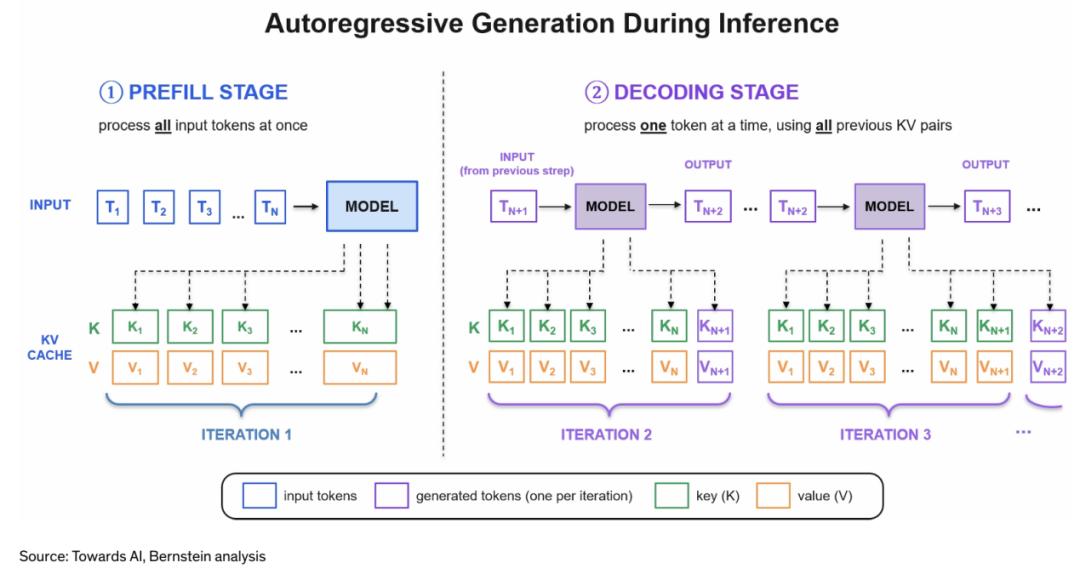
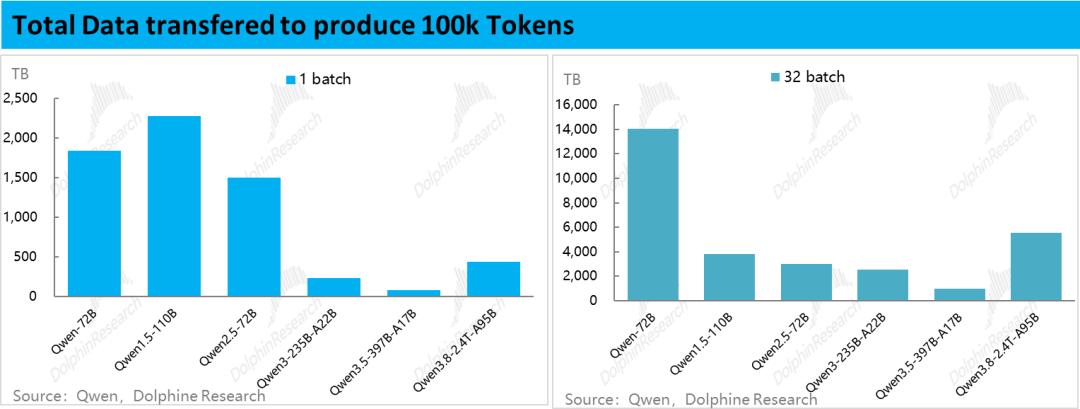
b. 以平方增长的推理计算量:对内存带宽高要求背后的另一原因,是大模型在推理计算中,需要读取的数据量是随着生成Token的数量,以平方而非线性速度增长。粗略的说,生成的上下文多10倍,需要的数据量要增长100倍。
背后原理如下图所示,是因为AI模型计算输出每一个新Token时,都需要完整读取一遍激活参数,以及此前全部的KV缓存。生成n个Token就需要把以上读取动作重复n次。(一个典型的等差数列求和问题)
根据海豚君的测算,以Qwen3.8 Max为例,在已有100k上下文的基础上,生成100k新token过程所需的数据读取的量级,在500TB左右。
但我们能看到Qwen3相比此前几代模型虽然参数量大幅走高,但对数据读写量需求却明显下降,这背后是软件技术进步降低了对硬件要求的体现。
这种帮助主要体现在两点,一是大模型架构普遍从“致密”转向“稀疏”(是同时激活所有参数,还是只激活部分参数),二是注意力架构从“全注意力”转向“混合/线性注意力”的作用。(生成token时,是需全量使用所有KV缓存;还是只有部分最相关的缓存全量使用,其他大部分缓存进行压缩使用)
但正如“杰文斯悖论”,软件技术帮忙降低了对硬件的要求,那么新的大模型会以更大的参数和上下文(达到数万亿乃至十万亿量级)把软件技术省出来的硬件资源重新用满。因此,即便有软件技术效率的进步,对数据读写量及读写速度的要求依然相当严峻。
并且我们此处的讨论是从单模型/单会话角度,再叠加上AI进入Agent和Coding时代后,AI的用户数量和会话量有爆发式的增长。单用户用量和用户数量双增的共振下,对存力的总需求自然会有成倍的增长。
训练阶段,存力不算大瓶颈
当然,以上我们只探讨了AI推理情景下对内存的需求,实际AI的训练阶段对存力有着不太相同的需求。不过整体上在训练阶段存力就不特别算瓶颈了。对此海豚君只简单介绍下。
概括来说,训练阶段对内存容量的要求,高于对传输速度的要求。原因是:
a. 对容量需求更高,首先是不同于推理时参数是已经完成计算的确定值。训练阶段内,还需要存储参数的中间状态及计算过程(打比喻的说法,具体术语这里就不展开了)。且不同于推理阶段的参数可以用FP4等低精度存储,训练时仍需以BF16或更高精度来运算。
因而训练阶段储存参数需要的内存容量能达到推理阶段的8~16x。但即便如此,训练时内存的容量也不算特别瓶颈。因为训练时整个算力集群可以都只用于一个模型的训练,内存容量相当富余。而推理阶段,整个算力集群是被切分成块,每个模型实体可用的资源一般只会有几十到数百卡而已,因此才会出现明显容量瓶颈。
b. 至于对数据传输速度的要求也不高,则是因为训练需要的计算强度远高于推理阶段。此时GPU的算力能被充分用满,不太会出现GPU因需等待数据传输而被闲置的情况。
02 HBM何以脱颖而出?
由前文可见,AI对内存的要求主要体现在更大的容量和更高的传输速度上,那么从技术角度看,HBM是如何满足以上两点要求,并脱颖而出成为目前高性能GPU内存的主要选择?
实际上,HBM内存相比常见的DDR内存,在内存颗粒上并没有质的区别,核心差异主要在不同的架构和封装方式上。
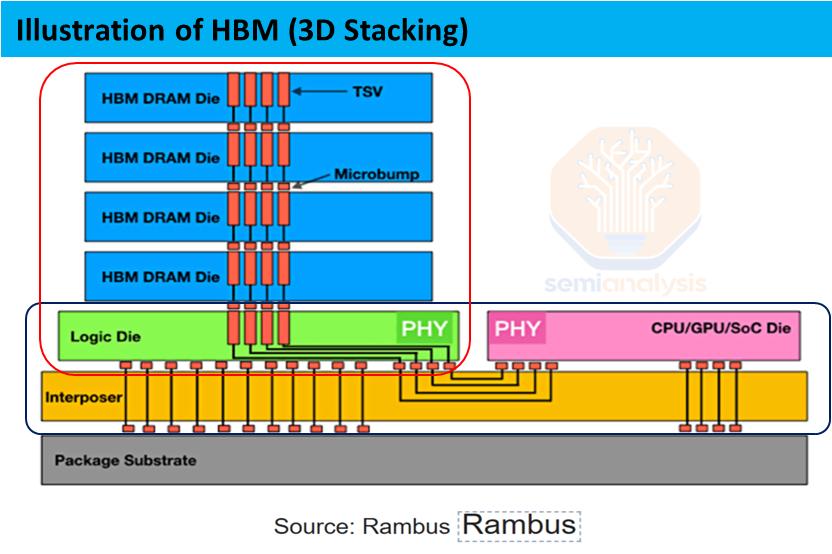
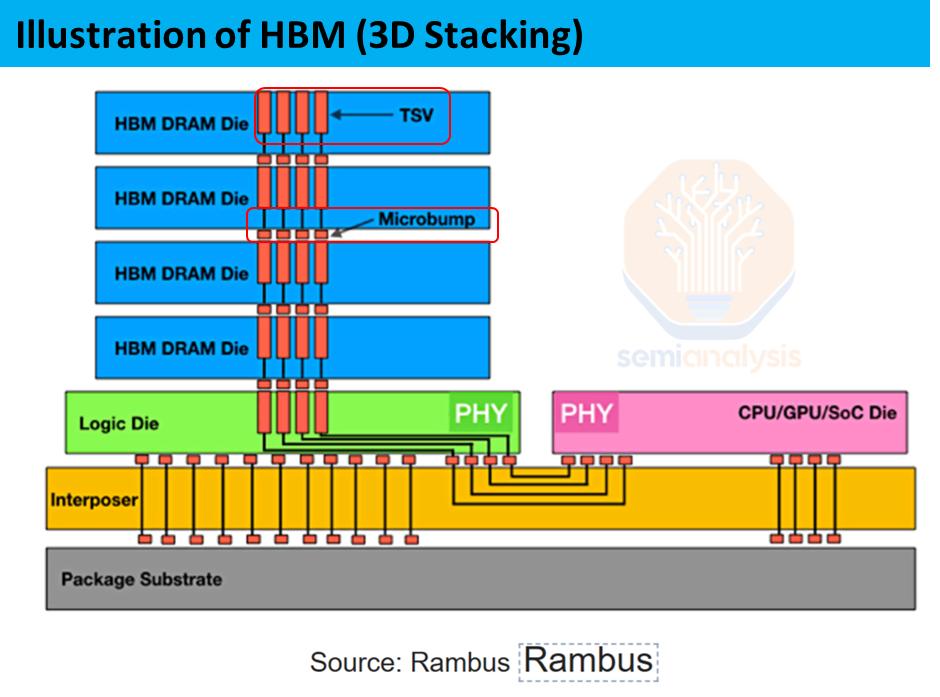
下图是一个HBM芯片的架构示意图,从中可见HBM的主要独特之处在两点:1、HBM的内存颗粒(DRAM Die)是在竖直空间内一层层堆叠起来的,2、HBM是和GPU安装在同一介质层上(硅中阶层),共同封装在一起的。正是这两项技术共同实现了高容量和高传输速度。
其各个重要构成部件包括:① DRAM Die即实际的内存颗粒,② Logic Die / Base die,内存颗粒底部的管理芯片,③ TSV 用于跨颗粒层传输的硅通孔,④ Interposer,一层硅介质,用于安装并联通内存和GPU。后文我们会一个个详细介绍这些部件。
堆叠技术提升容量:
首先,要扩大内存总容量逻辑上有两个方式,一个是增大单个内存颗粒的容量密度,另一个是尽量在同样体积内“塞下”更多数量的内存颗粒。
简单来说,颗粒的容量密度主要由制程精度决定,但因物理规则的限制,内存颗粒的制程又很难做小。若制程太小,容易导致内存中的电子“突破限制地乱窜”、造成数据错乱或丢失。
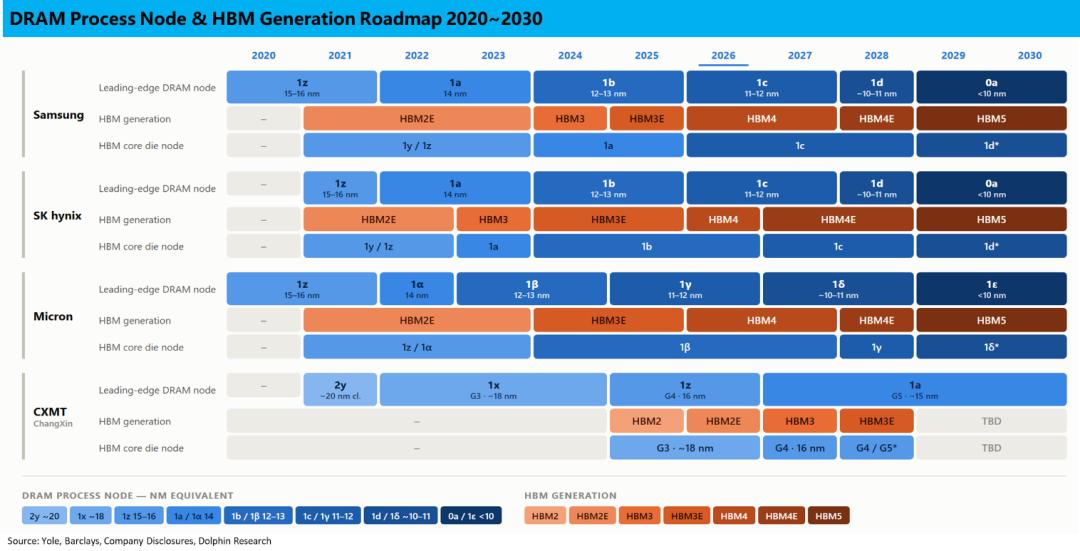
因而目前内存最先进的制程只在11~12nm左右,预期到2030年也只能做到10nm左右,相比逻辑芯片2~3nm的制程技术,差距很大。
因此不同于逻辑芯片的摩尔定律--大约每两年时间就能将单位面积内的晶体管密度翻倍\单位性能提升一倍。内存颗粒靠制程进步或者说提升单位容量密度的路不太好走,因而只能选择另一条更“简单可行”的方式,在给定的空间内尽量塞更多数量的颗粒。
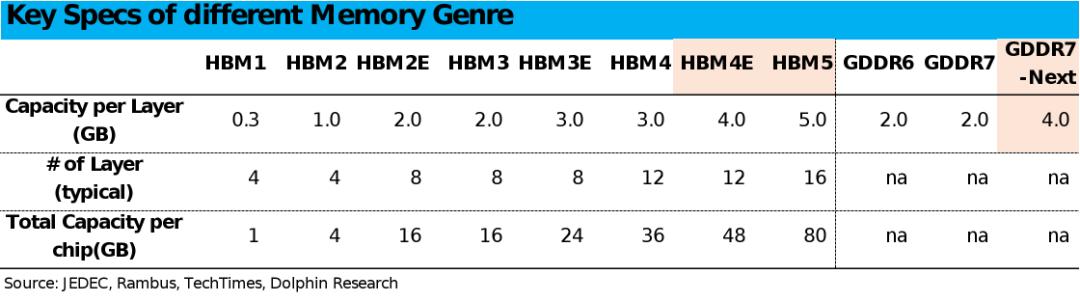
这就引出了前面提到的HBM采用的堆叠技术 -- 把多个内存颗粒一层层垂直堆叠在一起,从而在有限的面积下安装下更大容量的内存。由下表可见,目前最新的HBM4规格下内存堆叠数量已达12层,是初代的3x。根据部分报道,在26~27年之交新一代HBM将进一步把堆叠层数推高到16层。
珍贵的空间和边界:
但为什么不能像传统内存布局一样,把大量内存颗粒平铺在基板上来实现更大的总内存容量?
根本原因是,高性能GPU内能用于安装内存的位置和空间非常有限。在上文已有提及,是为了更高的传输速率,HBM内存需要紧贴计算核心安装,共同封装在一块单独的硅中介层上。
a. 由以下的主板实拍图清晰可见,普通家用GPU上,银白色区域内只有运算核心,内存颗粒是环绕安装在四周的黑色板材上(PCB板)。
而服务器GPU的HBM内存颗粒则是紧贴着GPU核心,一同安装在银白色区域内。而这块区域的面积有限、且目前没法做得太大,因而能用来安装各个部件的空间很有限。
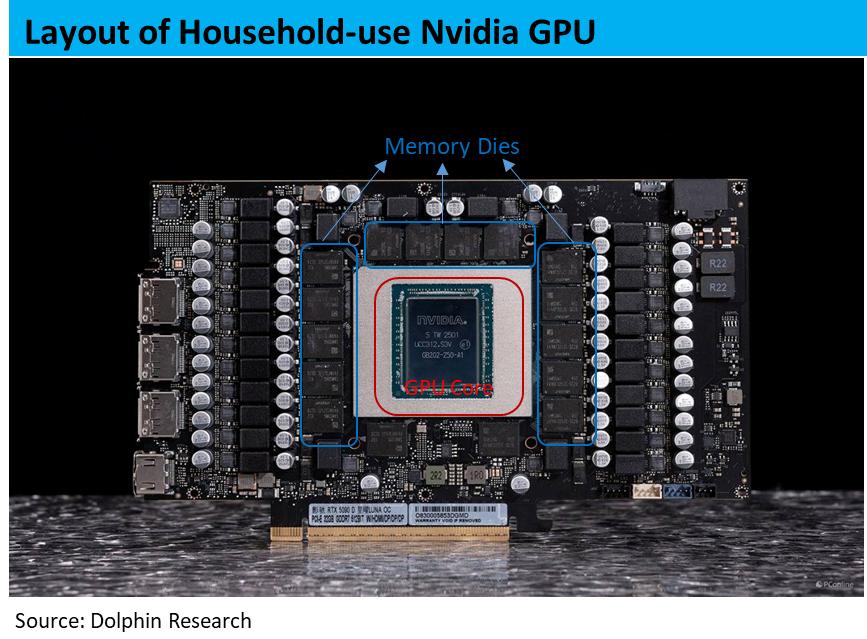
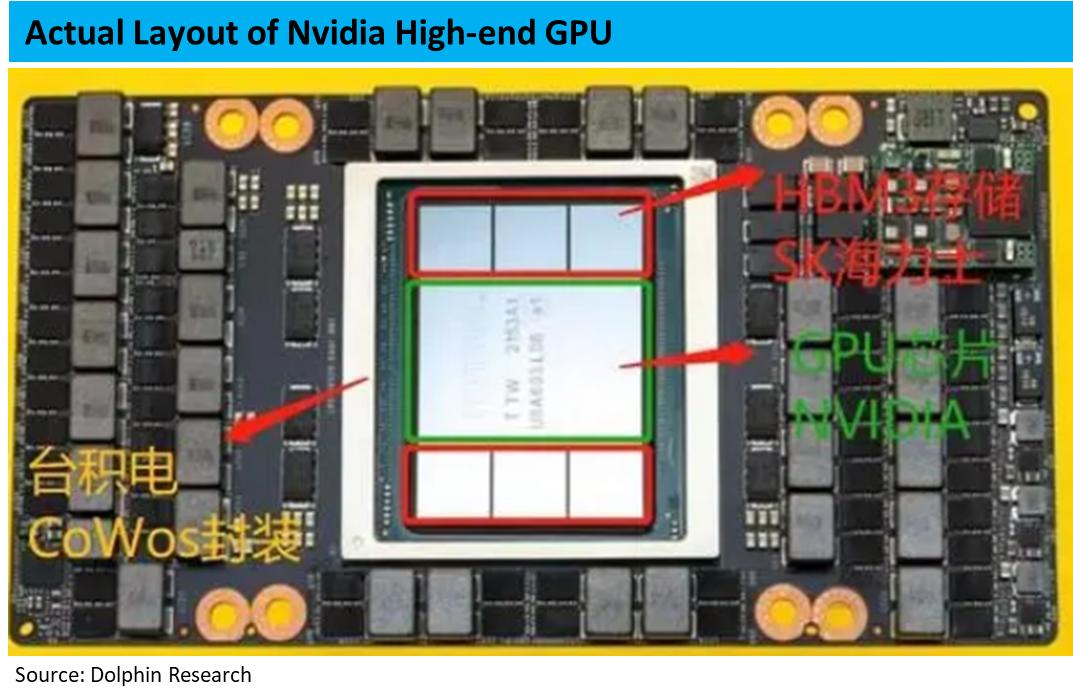
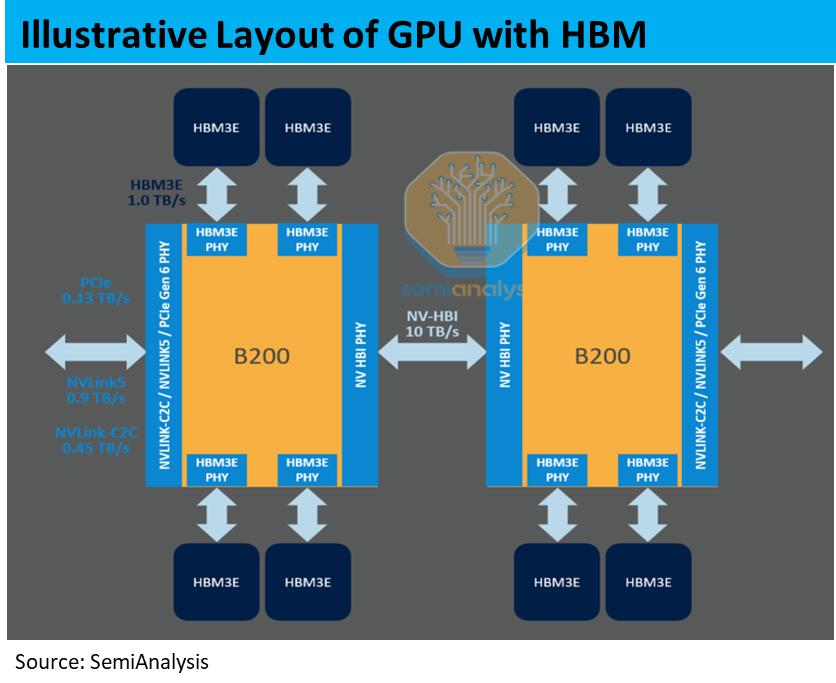
b. 另外从图上也可见,HBM颗粒只安装在GPU的上下,左右是空着的。这是因为传输部件(I/O)只能布置在计算核心的四边。这四边中还需留出位置给核心之间内部相互通信的模块,以及GPU与外部通信的模块。因此能留给内存的位置就更少,无法在芯片四周铺满,这两个因素共同限制了内存在水平面上安装的空间,因此只能向垂直角度堆叠。
03 HBM的技术难点
以上我们简述了HBM带来的技术优势,但由此带来的代价--技术难点有哪些方面?接下来我们一一介绍。
堆叠的难点
a. 硅通孔--TSV
堆叠技术带来的第一个问题是,悬空堆叠起的内存颗粒之间要如何相互联通、传递信息和电力?这就引入了一个堆叠技术下新增的重要功能器件--硅通孔或者叫TSV。
仍沿用此前的示意图(注意红框内),硅通孔简单来说就是在硅片中垂直打孔,然后填充进铜作为导体,进而获得在竖直方向上通信和输电的能力。再在每一层底部增加和通孔对应的微凸块,把每层颗粒上下联通起来的同时,又要在每层间保留一定间隙,以防止短路并利于散热。
制造硅通孔算不上技术的“难点”,各内存厂商自身的工艺都可制造,但额外工艺和步骤自然意味着更高的成本,以及更低的良率。同时,由于TSV需同时兼顾通讯、通电、散热等多种功能,不同的设计布局和制造良率也是区分内存厂商优劣势的其中一点。
b. 焊接工艺各不相同
凭借TSV和微凸块能实现各层颗粒之间的互通,但还需要进行焊接和封装来确保这种精密的堆叠结构能长期稳定可靠。
海力士目前采用MR-MUF工艺(MR指回流焊、MUF指一种液态树脂),而三星/美光则采用TC-NCF工艺(TC指热压、NCF指非导电膜)。
概括来看,TC-NCF的工艺流程是:① 在第一层的内存颗粒背面贴上固态非导电薄膜,② 上下两层颗粒对齐,加热加压,让上层的微凸块穿透薄膜与下层芯片的接口融合,③ 薄膜层受热融化、填充两层颗粒间的所有空隙,冷却固化起到固定和绝缘作用,④ 循环往复以上步骤,直到所有颗粒层都完成焊接固定。
而MR-MUF的工艺流程则是:① 将所有颗粒层一次性全部对准叠好,涂抹助焊剂临时固定,② 将整个堆叠置入回流炉,加热部分融化微凸块,一次性完成各层所有焊点的熔接,③ 注入特制液态树脂(EMC),一次性填满各层之间的所有空隙,包裹住整个芯片;④ 树脂固化后,研磨去掉多余树脂。
对比来看,MR-MUF技术的主要优势在于生产效率更高,良率更高以及散热性能更好,因此具备更高的毛利率,这也是海力士的关键竞争优势之一。
背后的技术原因是:① 热压技术需一层层堆叠焊接,一层出错整体报废。而回流工艺(MR)一次性焊接成型,步骤更少因而效率更高;② 反复热压容易导致很薄的硅片弯曲变形或开裂,或导致凸点损坏,因而良率更低。
那么为什么三星和美光不模仿MR技术?一方面是海力士对该工艺申请了多个专利,且关键材料--液态树脂是海力士与上游供应商合作研发的,限制了竞争对手使用。另一方面,三星美光已在TC工艺上做了大量研发和设备投入,转换成本较高。
相比复刻海力士现有的MR技术,三星和美光更倾向于直接研发下一代混合键合技术,以实现弯道超车。不同的键合技术也是区分内存厂技术优劣的因素之一,对这点后续我们也将进一步讨论。
共同封装
前文我们提到,为了让计算核心和内存之间的数据传输更快,HBM必须和GPU芯片紧贴着封装在一起,为此还极大限制了内存安装的位置,可以说代价不小。那么背后的技术原因是什么?
首先一个简单的公式,内存带宽(也就是数据传输速度)是由频率和位宽两个指标决定的,等于这两个指标的乘积。通俗来说,位宽表示内存和计算芯片之间有多少条并发的数据传输通道,而频率则代表每一条通道传输数据的速度有多快。
由HBM内存和普通GPU使用的GDDR内存的规格对比表可见,HBM的带宽远超GDDR的核心原因是,HBM的位宽可达1~2千位,而GDDR则只有32位。而论单通道的传输效率,HBM反而明显低于GDDR。
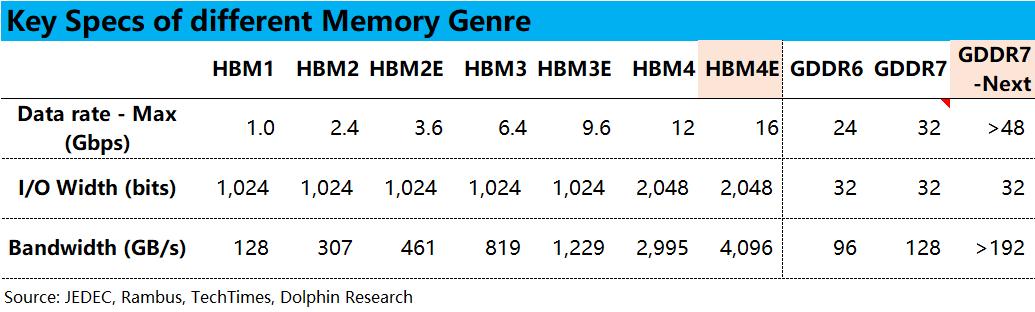
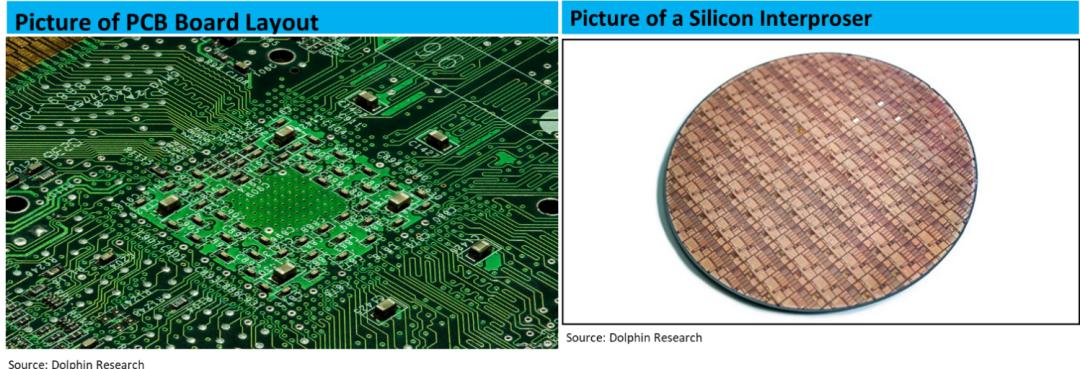
但要在有限的面积内,在内存和计算单元之间布下数千条通路连接,且还需保证每条通路之间不相互干扰,势必要求每一条通路都必须极其的窄。此时,PCB板的制作精度已无法满足,只有制造芯片的半导体工艺才能达到这种精度要求。
具体来看,PCB板的制作工艺是化学刻蚀,其能制作的通路宽度一般为50µm上下(下图中PCB的线路仍能肉眼可见)。而由半导体工艺制作的硅中介层上的通路宽度可以达到1µm左右。这正是需额外制作一块硅中介层来安装并连接HBM芯片和GPU核心的根本原因。
基座芯片定制化
和硅中介层的情况类似,整个内存模块有另一个组件--位于堆叠最底层叫做基底层或逻辑层,从HBM4开始同样也需要部分依赖外部厂商代工或协同设计。
基底层的作用简单来说就是向上支撑并联通其上的内存颗粒堆,向下通过中介层联通外部,实现与XPU的信息交换并获取电力,类似一个中转站。
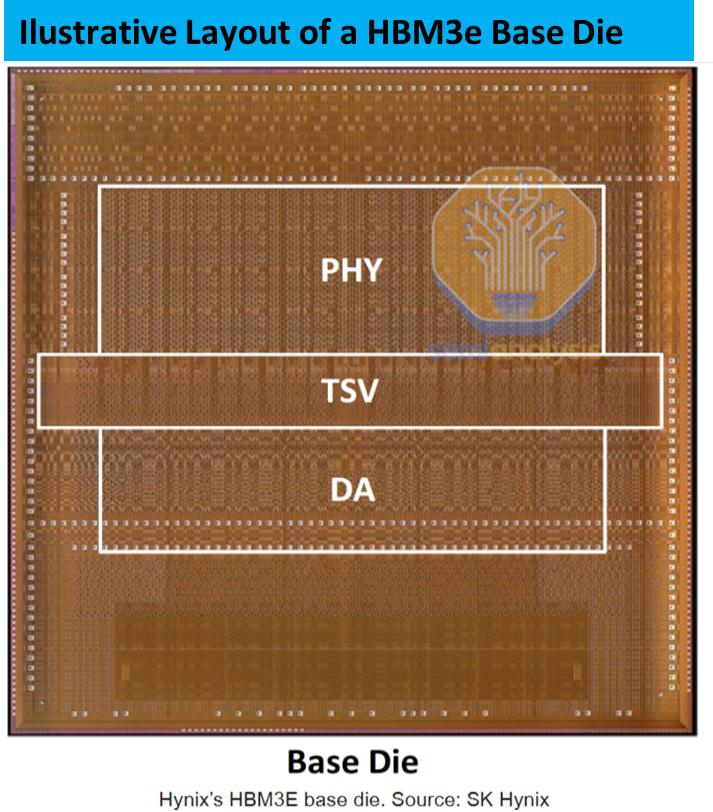
a. 在HBM3e及前代产品中,基底层的结构相当简单,包含3大部分:用于和XPU通信的PHY模块,和内存颗粒联通的TSV模块,以及用于封装前测试内存是否合格的Direct Access(DA)模块。
由于结构简单,此前基底层的制作工艺要求不高,20nm上下即可,因而内存厂商自己就能设计生产。
b. 但最新的HBM4中,基底层的制作工艺要求也普遍升级到了12nm左右。接下来的部分旗舰产品更会用到最新的2/3nm技术,同样需要由台积电等厂商代工(三星由于有半导体工艺,可以自己生产)。
至于背后的原因也很简单,HBM4中的基底层包括的模块和功能更多了,因而必须要提高工艺精度。具体来看:一方面是HBM4的位宽相较前代增加了一倍(从1K到2K),那么其对外连通的PHY模块就需要以更高的精度制造(或者大幅增加模块面积但不可行);
另一个更重要的原因是,在HBM4之后的版本中,原本位于XPU内部的内存控制器、地址映射管理等功能组件将被转移到内存的基底层模块中。这样也能让内存控制模块在物理上更贴近内存本身、减少指令和数据在内存和XPU之间的传输次数,也能在XPU芯片中节省出宝贵的空间用于其他组件。
c. 除了需要更精密的工艺制造之外,另一个重要变化趋势是HBM的基底层正逐步由通用组件变成客户专用的定制化组件。
例如英伟达自己公布的NVHBM规格中,将采取私有的Die-to-Die协议取代通用JED
内存已不再只属于“内存厂”
概括来看,以上提到的共同封装,以及需定制并由半导体厂商代工的基底层,这两个需要的新步骤/工艺,对HBM内存行业的影响是:
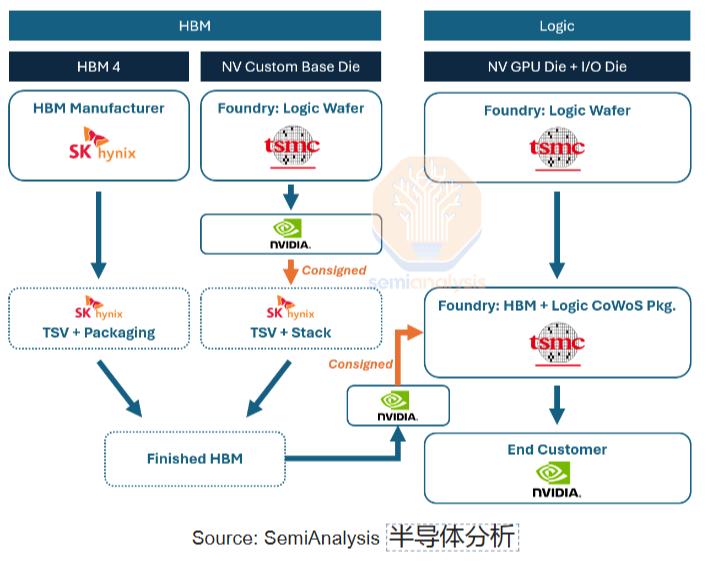
a. 内存厂商实际能交付的HBM产量,不再仅由其自身的产能所决定,也取决于其能够拿到合作代工厂的基底层制作产能和合并封装产能(主要是台积电的CoWoS产能),或者说高性能内存已然成为内存厂、封装厂和终端用户的共有产品。
b. 新一代HBM芯片的规格和设计也不再能由内存厂自身主要完成,而是和其下游客户共同设计决定。这意味着之后的HBM内存产品可能更加的定制化而非通用化。因此,内存厂商如何和大客户深度绑定也变的更加生死攸关,一旦大客户改换内存合作伙伴,可能很难找到新客户消化此前专门研发的产品。
以海力士的HBM4内存为例,只有内存颗粒的生产和堆叠是由海力士单独完成,其基底层是和英伟达共同设计并由台积电制作,最终的封装也是由台积电完成。
从这个角度看,内存厂商的独立自主权是有所下降的,对应在链条中占据的价值量份额也可能呈走低趋势。但因为AI导致HBM等高性能内存整个产业链的总价值盘大幅增加,目前仍是各参与者都“共同富裕”的阶段。
04 尾声
通过本篇,可以看到无论是从需求角度还是技术角度,内存的两个核心因素就是容量大小&密度,以及数据传输速率这两点。也能看到目前内存技术的核心差异点主要就在于不同的堆叠和封装方式上。
在下一篇,海豚君将进一步探讨之后更新的内存会如何围绕容量、速率、以及成本这三个因素,做出进一步的改进或取舍。以及这些变化,会对内存行业及其中的厂商们产生怎么样的影响。敬请期待!
本文来自微信公众号 “海豚投研”(ID:haituntouyan),作者:海豚君,36氪经授权发布。
















