又一个开源大模型入局:主攻代码与智能体
开源大模型的赛道,正在被一批新玩家继续填满。
在过去两年里,从大厂到独角兽,主流玩家几乎完成了一轮开源盘面的抢位。但在代码与智能体这条被普遍看好的方向上,市场并没有出现绝对意义上的赢家——更小的激活参数、更强的任务执行能力、更低的部署成本,正成为新一轮竞争的关键词。
而现在,一个新的名字入场了。
近日,至知创新研究院(IQuest Research)正式开源新一代大语言模型 IQuest-Q1,模型权重与Blog同步开放:
GitHub:https://github.com/IQuestLab/IQuest-Q1
Hugging Face:https://huggingface.co/IQuestLab/IQuest-Q1
Blog:https://iquestlab.github.io/
1. 模型基本盘:一个不算大的 MoE
先看几个关键参数:
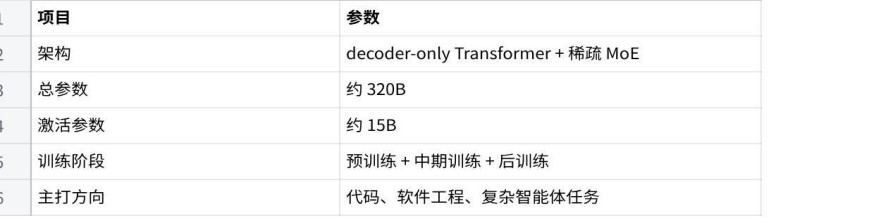
320B 总参 / 15B 激活——放到当下开源阵营看,这是一个偏"轻"的组合。
尺寸背后的判断并不复杂:随着大模型走向真实场景,推理成本、部署门槛和迭代速度开始压倒纯粹的参数量,成为团队们更关心的指标。IQuest-Q1 选择的是"控总参、压激活、堆后训练配方"这条路。
2. 榜单成绩:多项优秀,整体均衡
在官方公布的评测结果里:IQuest-Q1 在仓库级代码生成基准 NL2Repo 和网络安全基准 CyberGym 上展现出稳健的能力;同时,在 Terminal-Bench 2.1、代码长程任务基准 DeepSWE v1.1,以及面向专业办公场景的 JobBench 等复杂任务评测中,也表现出较好的任务执行能力。
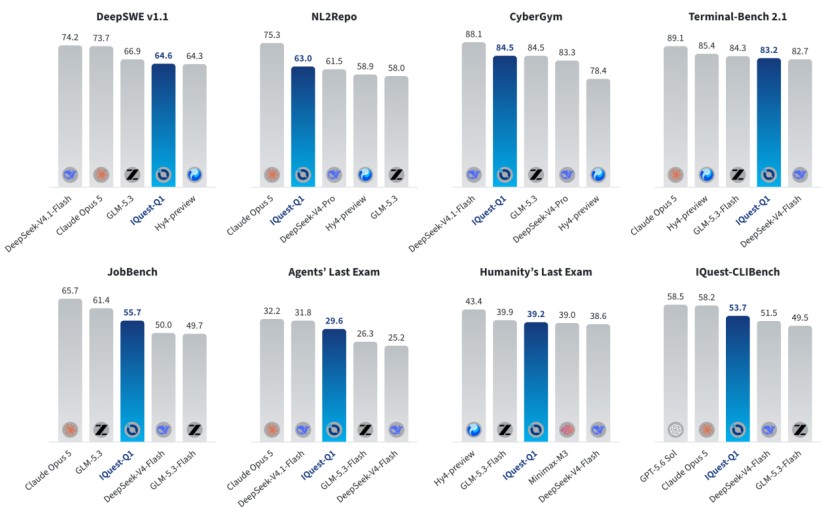
考虑到 15B 的激活规模,这份成绩单在推理侧留出了相当可观的成本空间——这也是它区别于同代大参数模型的最主要卖点。
3. 技术路线:MOPD + 三段式训练
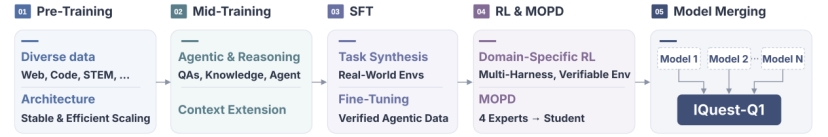
架构层面,IQuest-Q1 采用 decoder-only Transformer + 稀疏 MoE 主干;训练分三段:
• 预训练:奠定基础代码能力;
• 中期训练:向复杂任务过渡;
• 后训练:围绕软件工程、长时程任务和通用推理做专项训练,配合 SFT 与 RL。
在多教师能力整合上,团队采用了 Multi-Teacher On-Policy Distillation(MOPD),把多个教师模型的强项合并到一个小激活模型中——这也是当前"小激活对齐大模型能力"的一条主流路径。
4. 实测:模型开始"接活"
IQuest-Q1 的能力锚点被官方明确放在了"可交付结果"上。
在放出的几组任务演示里,模型的角色更接近一个能推动任务往前走的"执行者",而不是简单的"回答者"。
复杂交互应用开发
一句自然语言指令,直接输出可运行的交互应用。以 FPS 游戏为例,IQuest-Q1 一次性完成三维场景、角色移动、射击换弹、生命值、计分、敌人、Boss 战、资源与武器购买等多个模块,代码生成、多文件组织、交互逻辑、视觉呈现同时推进。
赛车游戏案例中,模型处理了赛道延展、前景与背景切换等空间连续性问题。
训练诊断与代码修复
一次 RL 训练异常后,模型自主完成读日志、看执行轨迹、定位问题代码、修复、验证的全过程。演示中定位到的根因是"训练轨迹中被插入了一个空格",修复后指标重新爬升。
复杂工作环境任务执行
接入聊天、在线文档、表格与评论等多类信息与工具,模型完成分析、生成文档、修订结果,最终输出可交付方案。
5. 结语
对整个开源大模型市场来说,IQuest-Q1 的加入本身并不是一个孤立事件。它更像是一个信号——这条赛道正在从"堆参数"的粗放竞争,转向"以效率换能力"的精细化竞争。
对至知创新研究院自己而言,他们是继续推进代码智能、复杂任务执行与模型自进化机制,还是进一步完善面向大规模模型研发的 AI-native 基础设施?接下来行业反馈会给出答案。
















