Claude Haiku 5.5 杀入低价战场,国产模型性价比还稳吗?
AI 圈的价格战,现在连小模型都不放过了。
Anthropic 正式发布 Claude Haiku 5.5,输入价格最低到每百万 Token 0.1 美元。
与此同时,它的电脑操作、编程和知识工作能力也迎来大幅升级,部分测试成绩已经能跟一批更高价位的模型掰手腕。
过去聊到小模型,大家的第一反应通常是便宜、快,但能力有限。遇到复杂任务,还是得请旗舰模型出马。
不到三周,Anthropic 连续更新 Opus 5.5、Sonnet 5.5 和 Haiku 5.5,三条产品线全部换代。
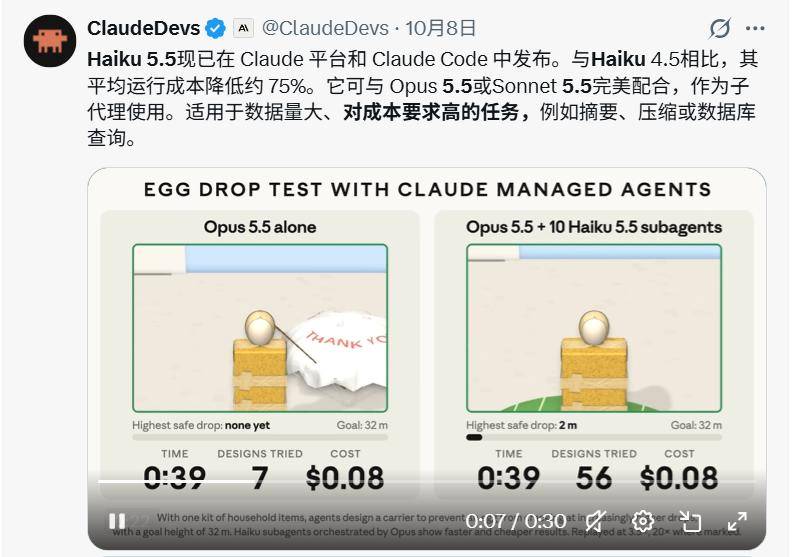
按照 Anthropic 的设想,Opus 5.5、Sonnet 5.5 负责规划和拆解任务,Haiku 5.5 进入多 Agent 工作流,接手大量重复、标准明确的执行工作。
能力暴涨,小模型不再打辅助
这次 Haiku 5.5 最明显的变化,不是某一项跑分小幅上涨,而是从过去相对薄弱的执行能力,开始向真正能完成任务的方向迈进。
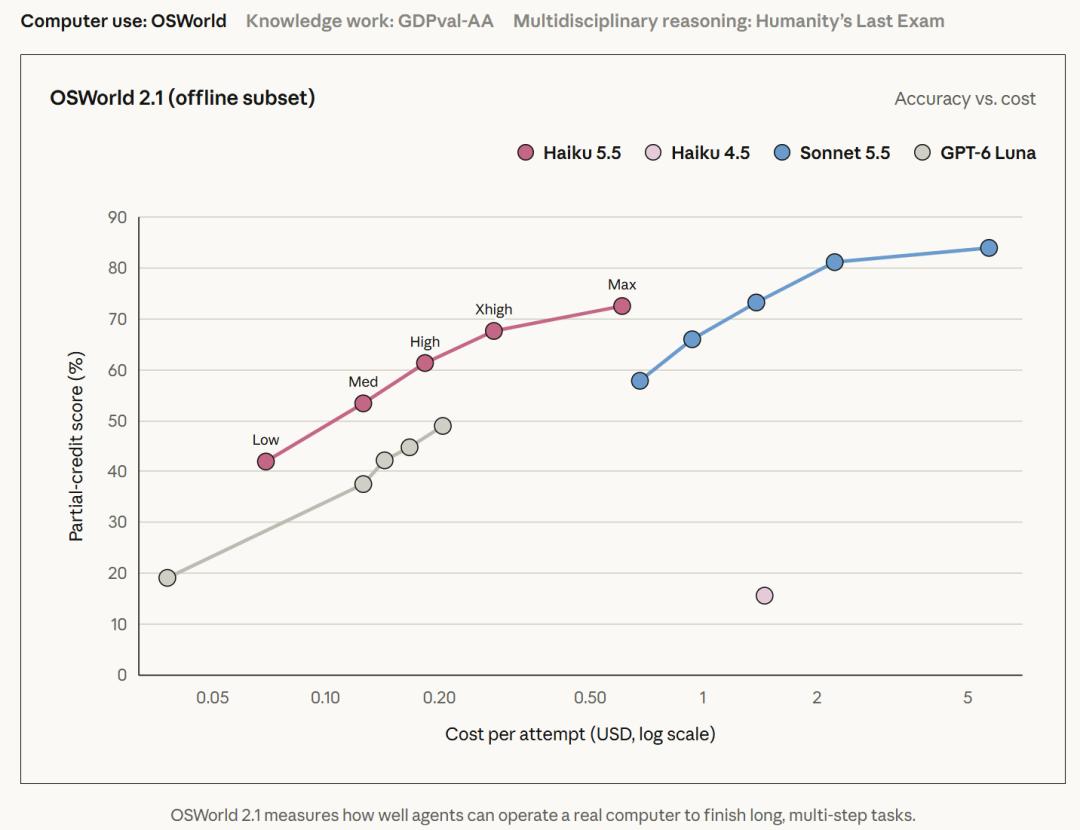
在电脑操作基准 OSWorld 上,Haiku 5.5 的成绩从上一代 Haiku 4.5 的 15.7% 一路涨到 72.4%。
这项测试考验的是模型能否像人一样操作电脑,完成一系列实际任务。
相比只会回答问题的聊天模型,这类能力更接近 AI Agent 真正需要做的事。
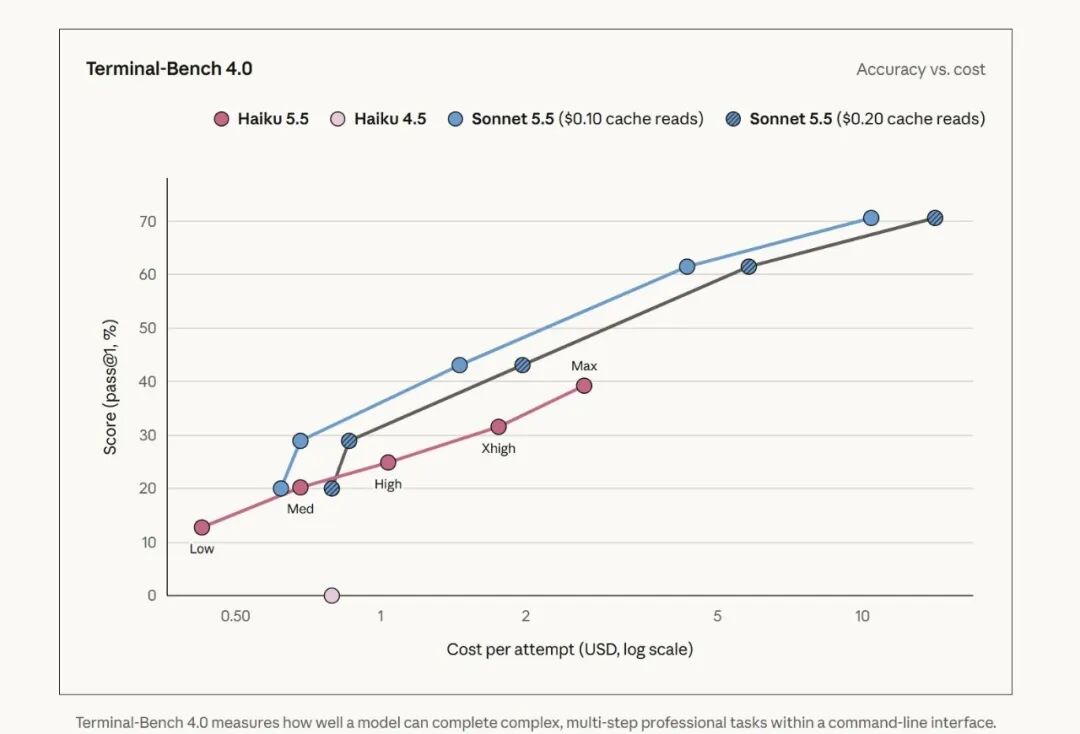
编程方面也有明显进步。在 Terminal-Bench 4.0 上,Haiku 5.5 从上一代的 0 分升至 39.2%,而 GPT-6 Luna 的成绩为 16.4%。
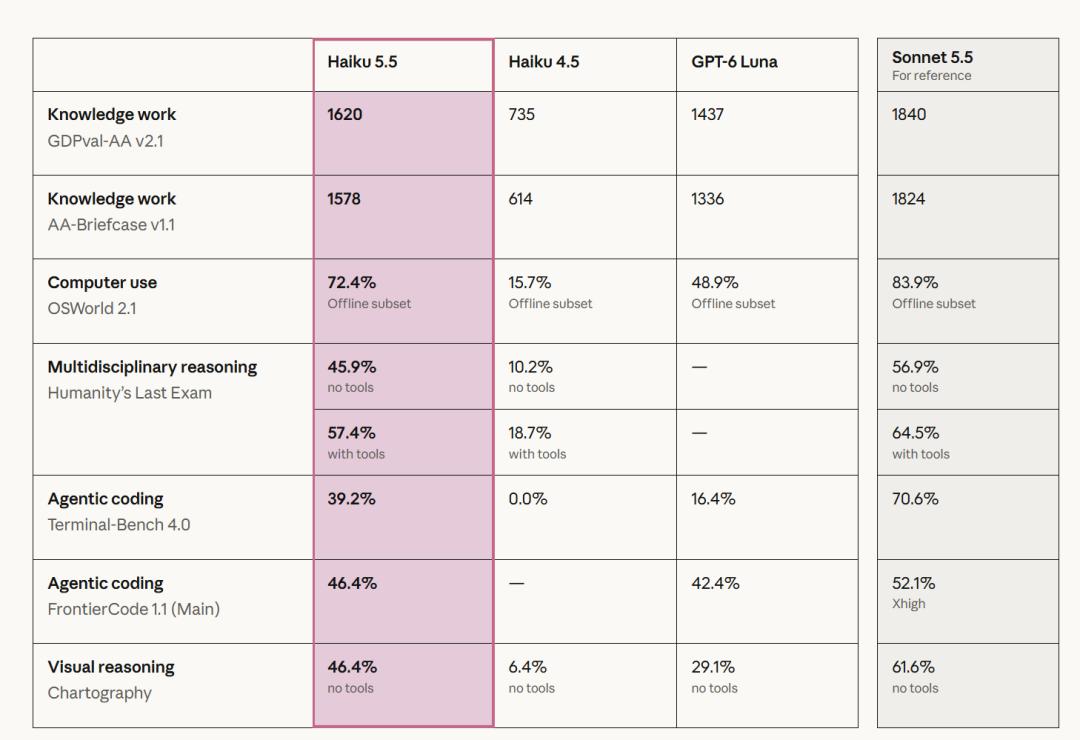
知识工作基准 GDPval-AA v2.1 的成绩,也从 735 升至 1620。
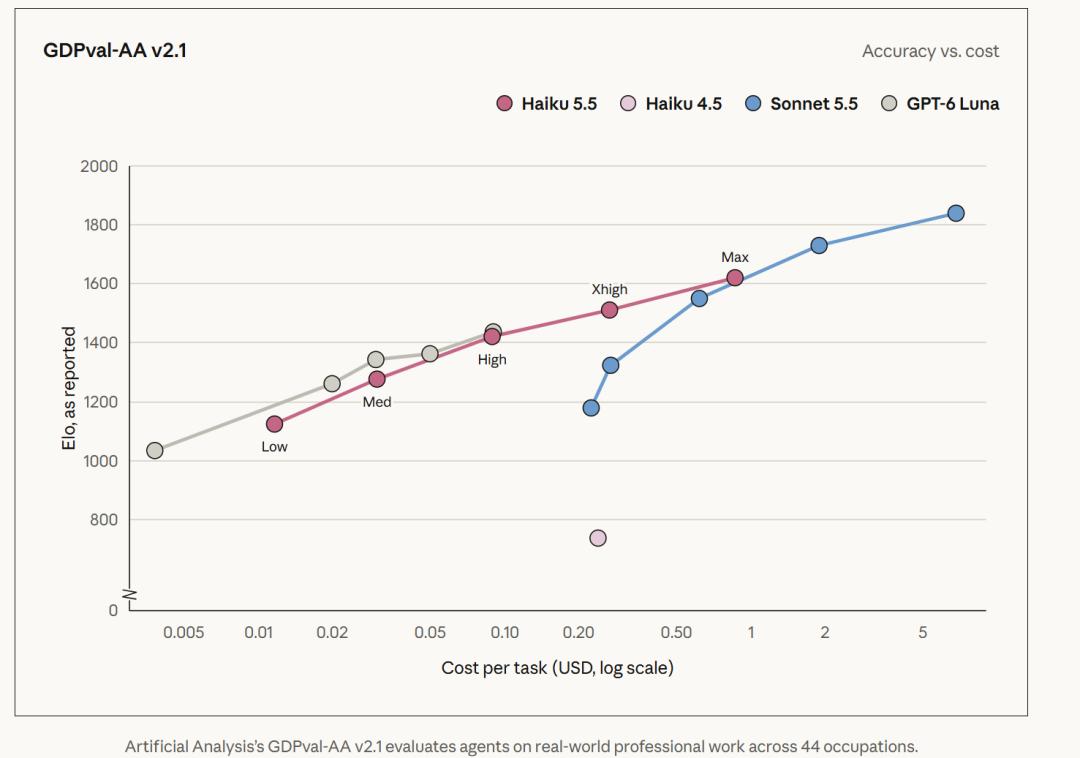
当然,Haiku 5.5 还不能直接替代旗舰模型。
以 Terminal-Bench 4.0 为例,它的成绩仍明显低于 Sonnet 5.5 的 70.6%。面对复杂的多步编码、跨文件重构和长周期自主规划,能力差距依然存在。
开发者 Pawel Huryn 在两个代码库中测试模型寻找遗漏 Bug 的能力,也得到了类似结果:
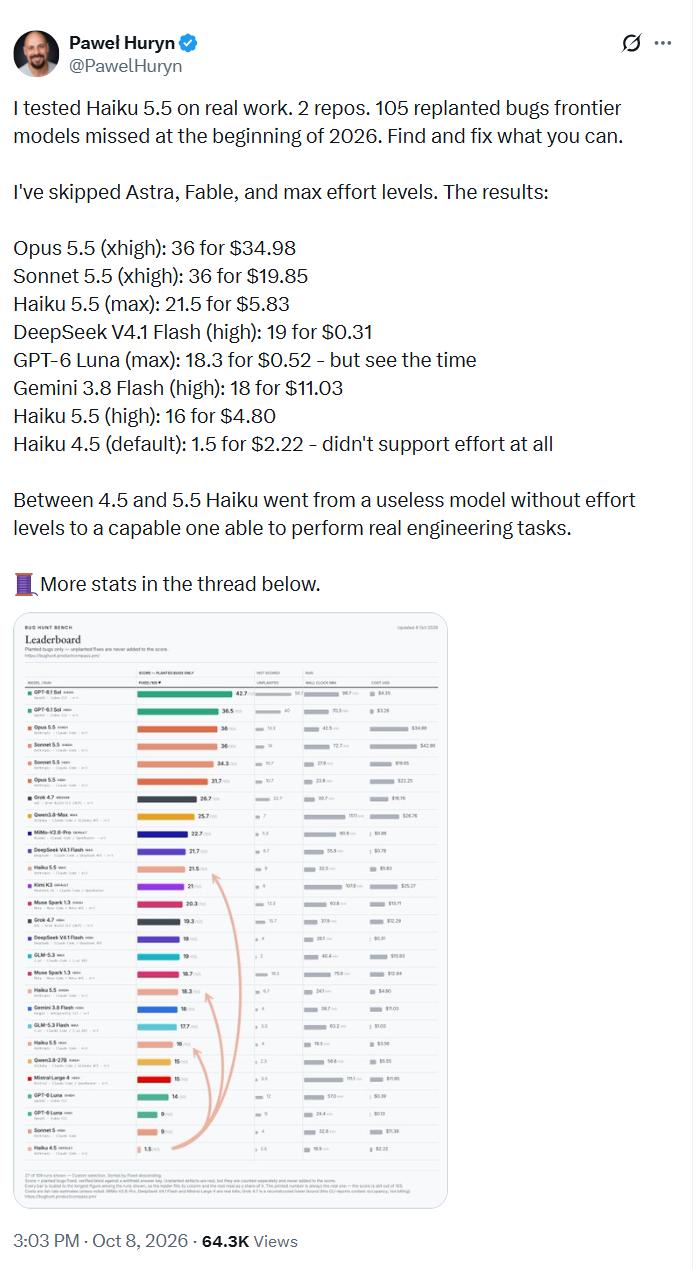
Haiku 5.5 的成绩距离旗舰模型还有差距,但找到的 Bug 数量已经大幅超过上一代,成本也低了不少。
另一个值得关注的升级,是 Haiku 5.5 首次支持 Low、Medium、High、Xhigh、Max 五档思考程度设置,可以按任务需要调整推理投入。
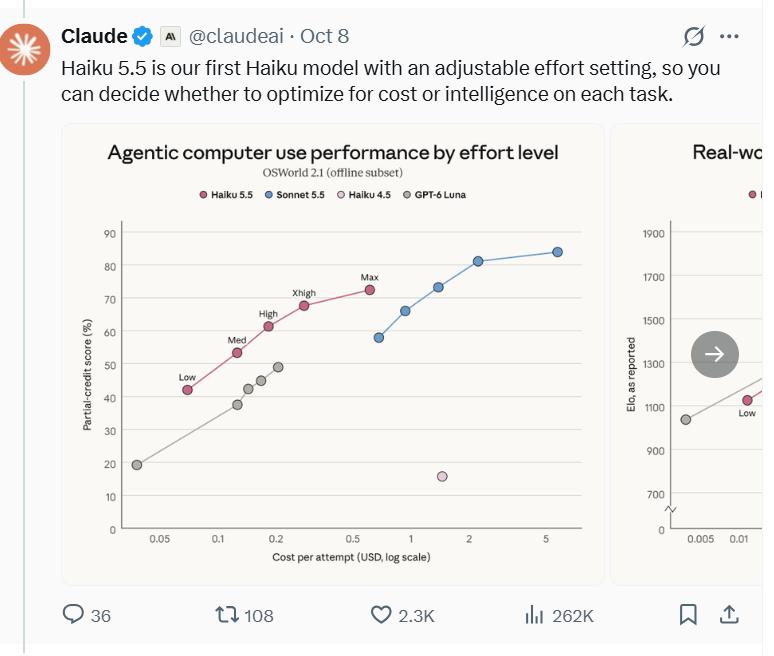
以 OSWorld 为例,Low 档准确率为 42%,单次成本约 0.07 美元;Max 档准确率达到 72.4%,单次成本约 0.61 美元。
相比之下,上一代 Haiku 4.5 的 Max 档准确率只有 15.7%,成本却达到 1.45 美元。
也就是说,新一代模型在低档位下,已经比上一代的最高档位更能打,而且更省钱。
价格又一次打下来了
能力上来了,Haiku 5.5 的价格也相当激进。
10 万 Token 以内,输入每百万 Token 只要 0.10 美元,输出 0.50 美元。
按照 Anthropic 的估算,综合使用成本相比此前下降约 75%,短请求的标价降幅最高可达 90%,但长请求的降幅会收窄。
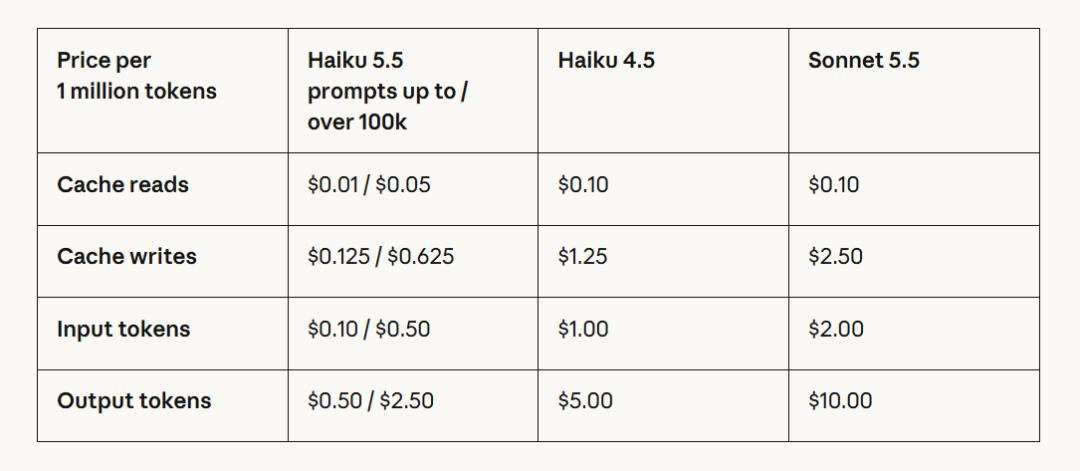
这个价格放在过去,确实很难想象。
但现在的问题是,AI 圈早就不缺便宜模型了。
DeepSeek、GLM、Kimi、MiniMax 都在卷性价比,Haiku 5.5 凭什么抢市场?
关键还是能力。
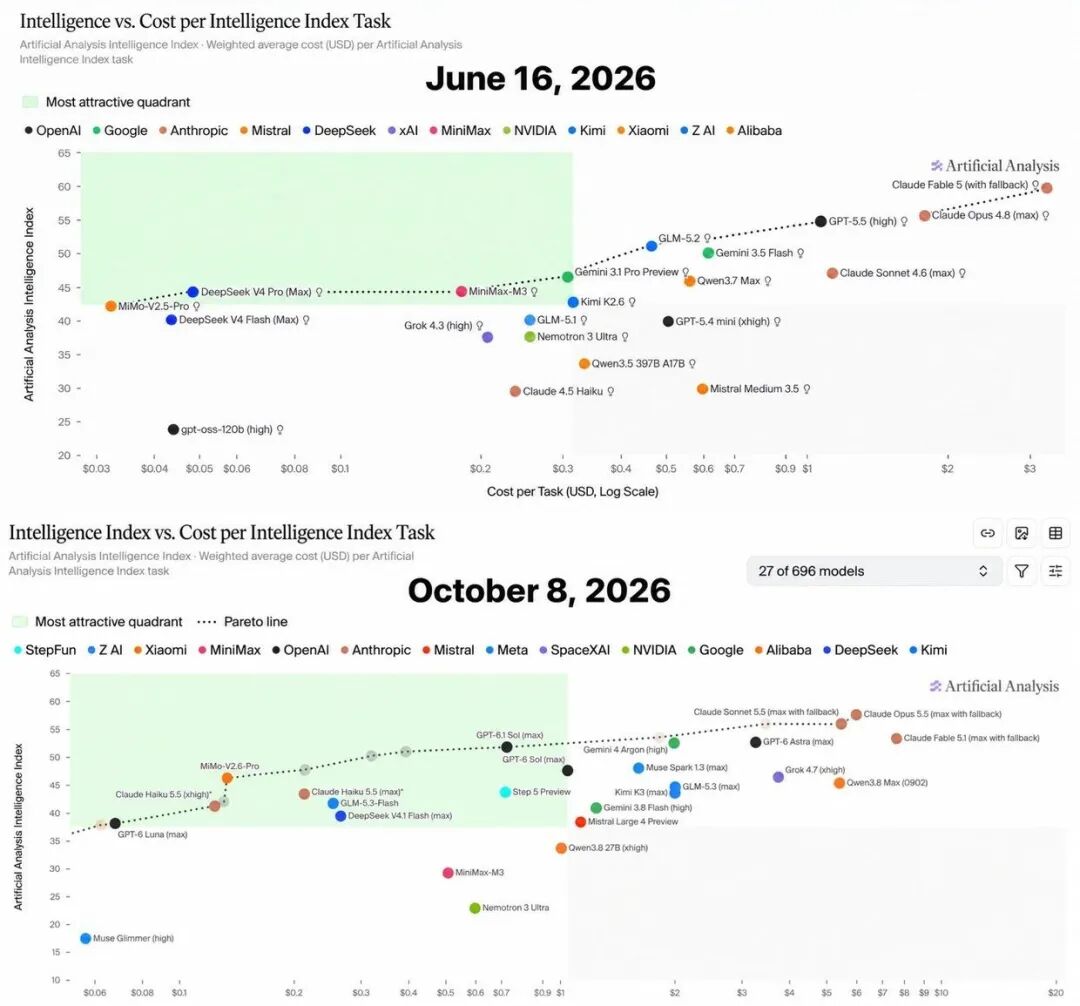
在 Artificial Analysis 的智能指数测试中,Haiku 5.5 得到 43 分,超过 DeepSeek V4.1 Flash 的 39 分和 GLM-5.3 Flash 的 42 分,与 Kimi K3 的 44 分也只差 1 分。
而上一代 Haiku 4.5 的成绩则只有 17 分。
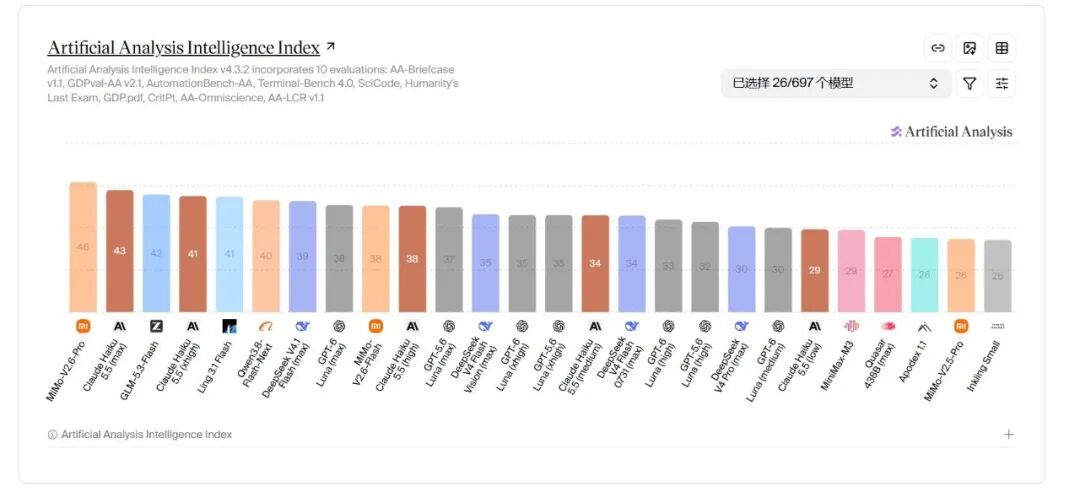
也就是说,它不是单纯把价格压低,而是在低价位上,把模型能力推到了一个更有竞争力的位置。
不过,单价低不等于实际使用成本最低。把 Haiku 5.5 和几款主打性价比的模型放在一起,竞争就更直观了。
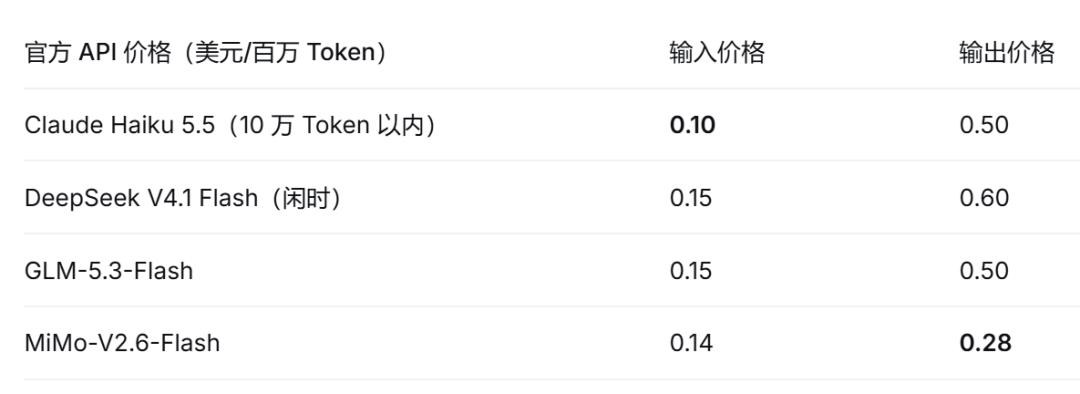
而不同模型的 Token 消耗和定价机制不一样,最终账单也会有差异。
尤其 Haiku 5.5 在超过 10 万 Token 后,输入单价会从 0.10 美元涨到 0.50 美元,长任务更需要精打细算。
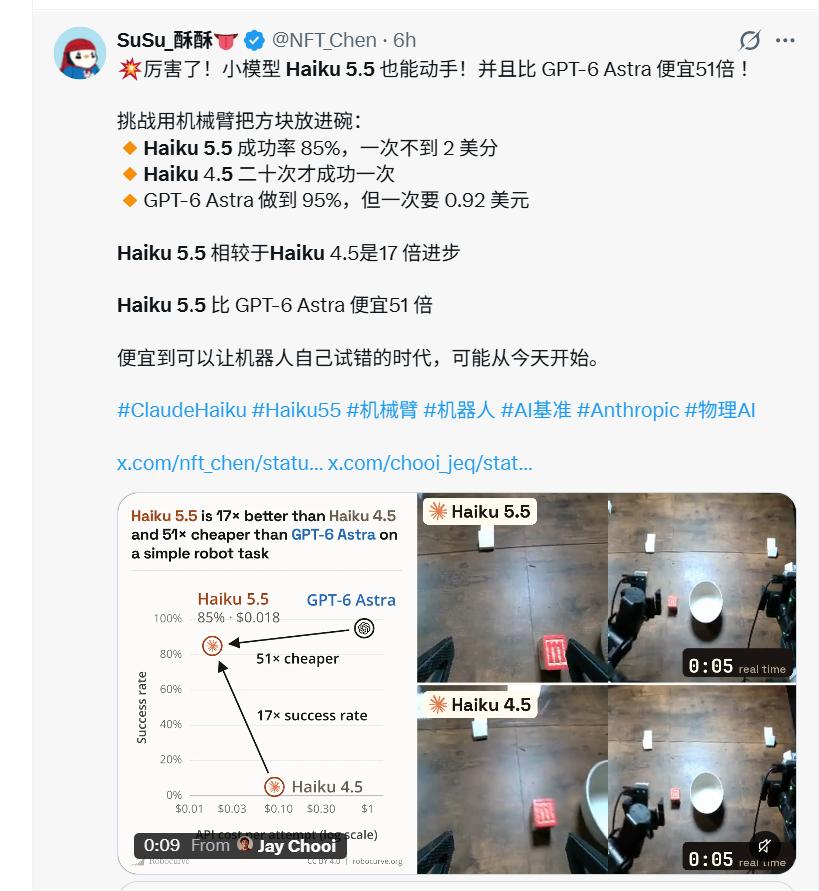
可以说,Haiku 5.5 在低价位上拿出了更有竞争力的能力,但不是所有场景都变成了最便宜。
对开发者来说,模型选型要算的是完成任务的总账:调用多少次、消耗多少 Token、需要多少轮修正,以及最后能不能把任务做对。
押注多 Agent 协作,更有性价比
Agent 工作流的成本,很大程度上取决于你让什么模型干什么活。
如果每个步骤都调用旗舰模型,成本自然降不下来。
Anthropic 的思路很直接:Opus 5.5、Sonnet 5.5 负责规划,Haiku 5.5 作为 Subagent 批量执行。
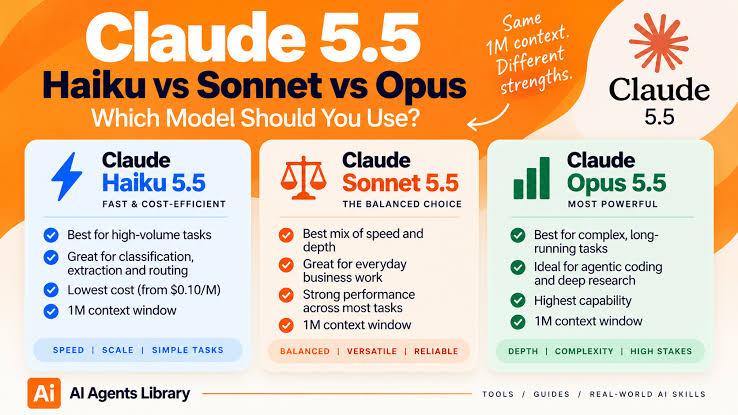
大模型拆任务,小模型干活,不必每一步都花旗舰模型的钱。
官方展示过一个实验:让模型设计鸡蛋从 32 米高处安全落地的方案。
Opus 5.5 单独执行,耗时 3 分 37 秒,尝试了 25 个方案,花费 0.47 美元。
换成 Opus 5.5 搭配 10 个 Haiku 5.5 Agent 后,耗时缩短至 58 秒,尝试的方案增加到 86 个,成本降至 0.14 美元。
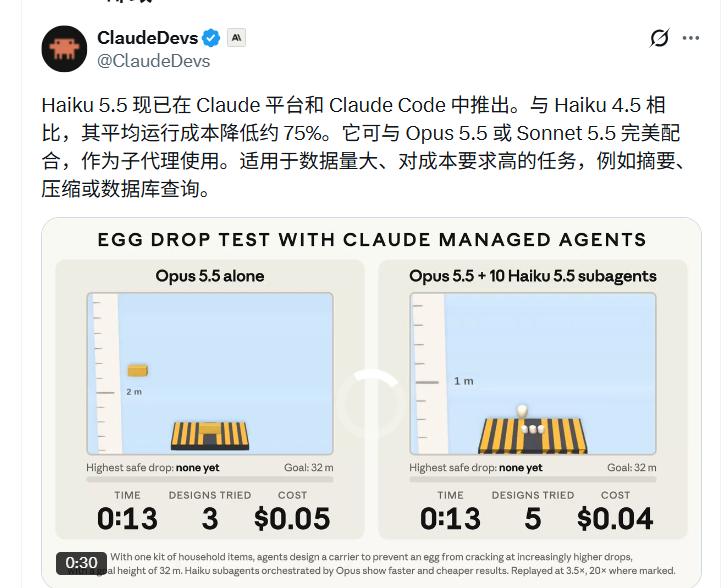
时间更短、探索的方案更多,成本还下降了约 70%。
这就是多 Agent 协作的价值:把任务拆开并行处理,让贵模型不必包办所有步骤。
开发者的实测,也提供了另一种观察角度。
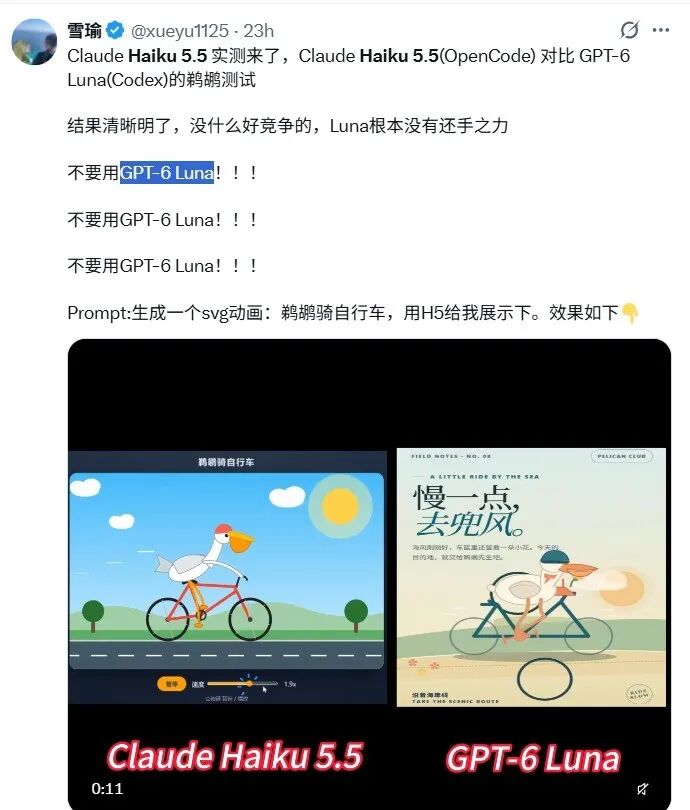
有开发者分别用 Haiku 5.5 和 GPT-6 Luna 生成“鹈鹕骑自行车”的 SVG 动画,并制作成 H5 页面。
从分享的成品来看,Haiku 5.5 的动画效果更好。
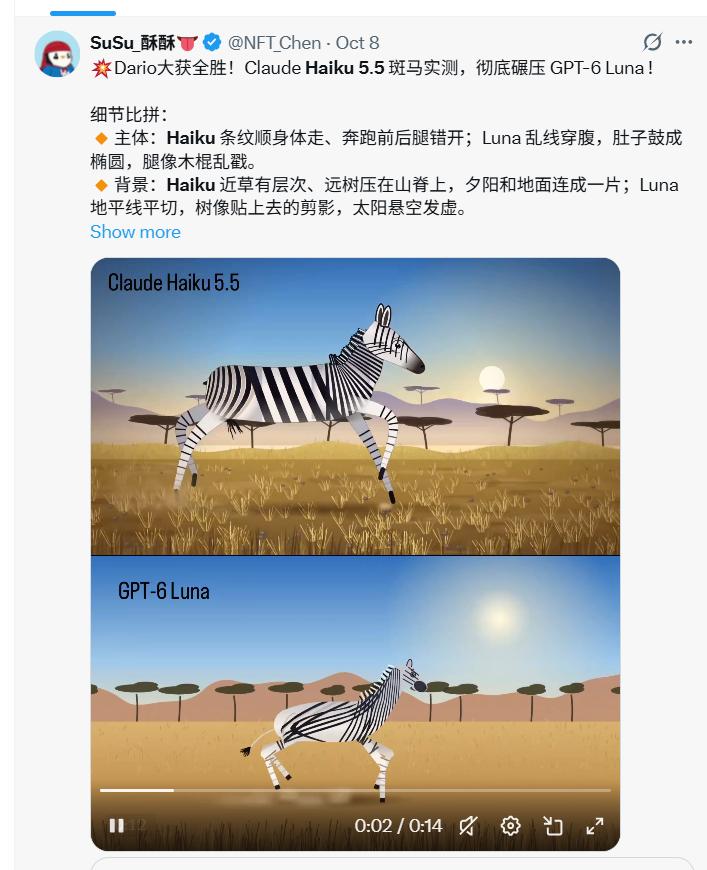
另一组斑马场景对比中,两个模型生成的斑马,重点比较身体条纹、四肢动作、远近景层次和草地融合。
分享者认为,Haiku 5.5 在细节上更好,对照模型在条纹、四肢和地面融合上问题比较明显。
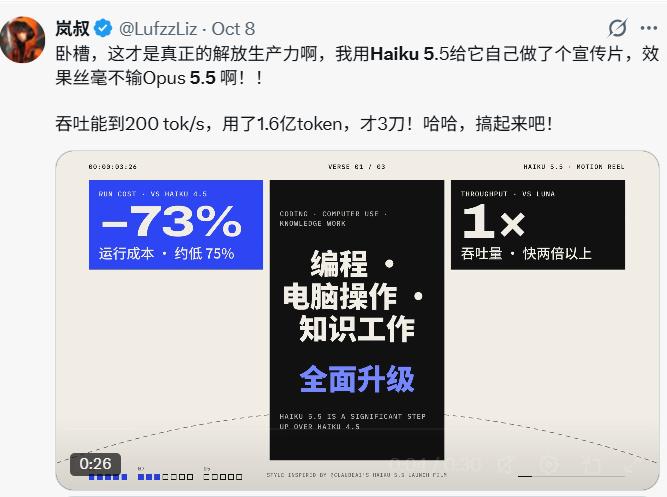
另一位开发者岚叔则用 Haiku 5.5 做了一支宣传片。
他表示,最终效果丝毫不输 Opus 5.5,模型吞吐速度达到每秒 200 Token,累计消耗 1.6 亿 Token,花费却只有 3 美元。
而工作流的总成本,恰好是中国模型厂商过去几年重点建立的优势。
DeepSeek、GLM、Kimi、MiniMax 等国产模型,靠低价和开放权重吸引了大量开发者。
如今,Anthropic 不仅把 Haiku 5.5 的短请求输入价格压到每百万 Token 0.1 美元,还通过 Subagent 和多 Agent 协作,试图把低价模型放进更大规模的任务执行流程。
这意味着,中国模型厂商面临的压力,不再只是 API 价格被追平。模型能否以更低成本完成真实任务,正在成为新的竞争焦点。
毕竟,开发者真正要算的,不只是每百万 Token 花多少钱,还包括完成一项任务需要消耗多少 Token、调用多少轮、花多长时间,以及最后要不要人工返工。
标价再低,如果任务跑不通,成本优势也无从谈起。
参考资料:claund 官网及公众号、X 等网络平台
本文来自微信公众号 “科技狐”(ID:kejihutv),作者:老狐,36氪经授权发布。
















