微软“站台”了一篇文章,说AI十年只能拉动1.5%的GDP
微软,OpenAI背后最大的金主,这波AI叙事最大的受益者之一,在自家刊物上,登了一篇唱衰AI的文章。
而且唱衰的这位,来头不小。达龙·阿西莫格鲁,Daron Acemoglu,MIT经济学教授,2024年诺贝尔经济学奖得主,当今在世的经济学家里被引用次数最多的那一档。
他的核心判断,可以先粗略地概括成一句话:
未来十年,AI大概只能拉动GDP增长1.5%,最多取代5%的工作。
你可能对这俩数字没概念,找个参照物。
就在今年,Google、微软、Meta、亚马逊这四家,计划往AI基础设施里砸的钱,合计约7250亿美元。一年的量。
而1.5%的GDP增量,拿美国的经济体量算,摊到十年,每年大概四五百亿美元。
一边是一年七千多亿的投入,一边是每年几百亿的预期回报。当然,这个账算得比较粗糙,经济学真不能这么算。
一. 发生了什么?
事情本身挺简单。
微软旗下有个刊物,叫《The Humanist Review of AI》,翻译过来大概是《AI人文评论》,画风相当老派,创刊号,作者署名用的还是手写签名,透着一股子知识分子的倔强。
阿西莫格鲁的文章就登在这上面,标题叫《Will AI Replace Workers? Not If We Build It Right.》,翻译过来就是:AI会取代劳动者吗?只要我们把AI造对了,就不会。
vist:https://humanistreview.ai/issue-1/acemoglu-ai-replace-workers/
文章页面标注的日期是7月15号,但真正被关注到是10月6号,媒体集中报道,微软AI部门的CEO苏莱曼当天晚上还亲自发了长帖推介,浏览量很快过了40万。
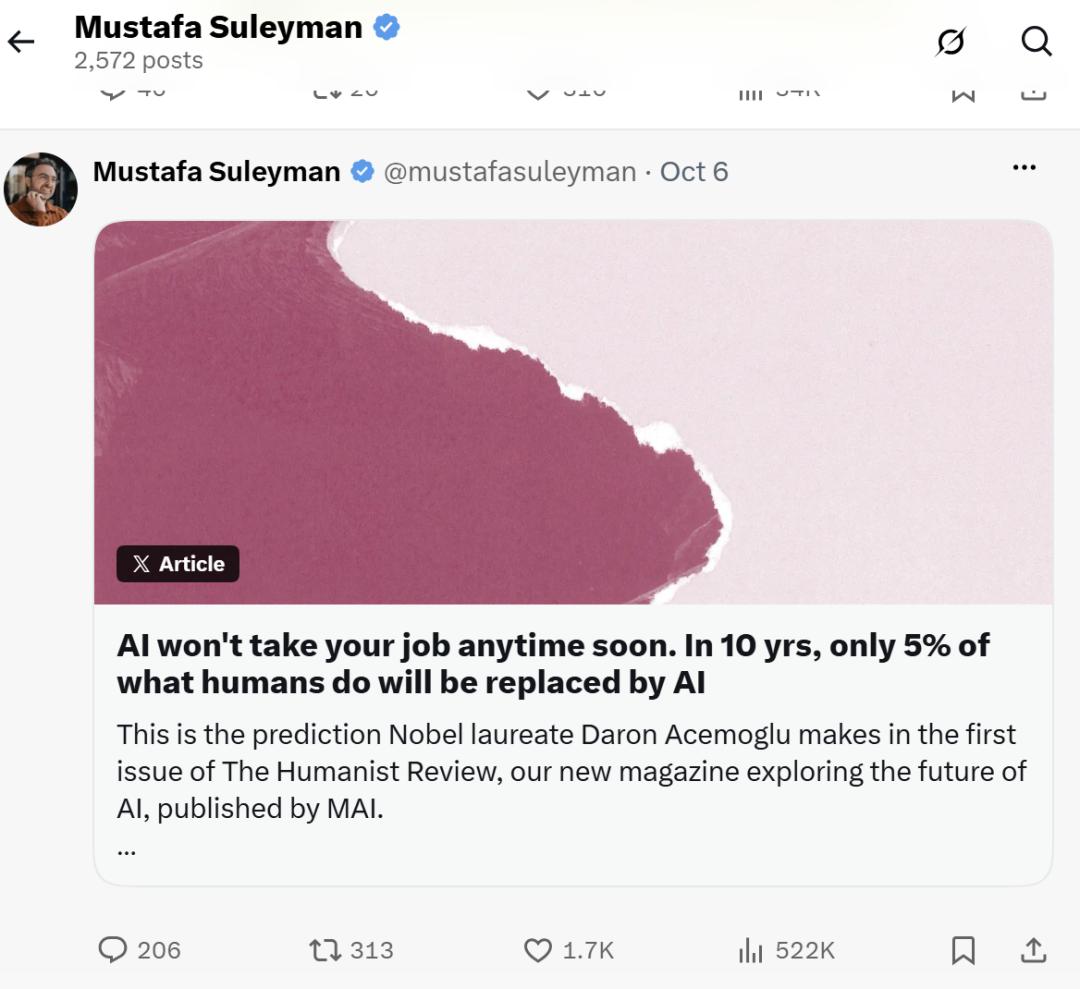
一个金主爸爸,给一篇唱衰自己赛道的文章亲自站台,你说拧巴不拧巴。
二. 先说说这个唱反调的人
阿西莫格鲁这个名字,你可能不熟,但他的书你大概率听过,《国家为什么会失败》,经济学出圈神作。2024年的诺贝尔经济学奖,就是他和另外两位学者一起拿的。
这人研究了一辈子三件事:技术、制度、增长。
关键是,他跟AI黑基本不沾边。他既不觉得AI是泡沫,也不觉得AI要毁灭人类,他烦的是另一件事:太多人闭着眼睛喊AGI,很少有人认真算账。
而且这也不是他一时兴起。早在2024年,他就发过一篇论文,叫《The Simple Macroeconomics of AI》,当时就估算,AI十年内带来的GDP增长,大约在1.1%到1.6%之间。
这次文章里的1.5%,正好落在那个区间里。
也就是说,整整两年,模型天翻地覆,从GPT-4卷到了GPT-6,全行业都换了人间,这哥们的预测,基本没动。
光这一点,就值得认真听听他到底怎么算的。
三. 5%这个数,是怎么算出来的?
他的算法拢共两步。
第一步,估AI能干什么。他判断,到2020年代末,AI能真正靠谱地自动化的,主要是简单的办公室认知类任务,这类活大约占美国经济全部工作的20%。至于那些需要判断力、多维推理、社交能力的复杂岗位,AI要啃下来还早,社会大概也不会放心让AI去管空管塔台、做心理治疗、执掌公司。跟物理世界打交道的活,更得往后排,灵活的机器人还没影呢。
第二步,估落地速度。参考电力、计算机这些老前辈的扩散规律,他判断,能自动化的活里面,十年内大概只有四分之一会真的被自动化。
20%乘以四分之一,得5%。
他自己都坦白,这属于guesstimate,翻译过来就是:学术化的拍脑袋。
但他给了两个挺硬的理由,解释为什么落地多半快不了。
第一个理由,是著名的索洛悖论。1987年,经济学家罗伯特·索洛说过一句名言:计算机无处不在,唯独不在生产率的统计数字里。今天的AI,处境有点像。实验室里写代码、看片子猛得飞起,可真到了公司里,工程师得花大量时间给AI写的代码擦屁股,放射科医生用了AI辅助,效果反而打折扣。
第二个理由,是电力的故事。1881年,纽约和伦敦就有了中央发电站,当时不少人觉得制造业马上要被掀翻。结果呢?到了1920年代,快四十年过去了,只有大约一半的工厂和家庭用上了电。
电力这种级别的技术都要熬四十年,AI要动的东西可能更多:任务要重新分配,员工要重新培训,管理层得从零学习怎么跟AI协作。组织的变化,往往比技术慢得多。
所以"放射科医生马上要消失"喊了快十年,现实是,医院里的放射科医生越招越多。
四. 一段关于语音识别的往事
接下来这段,是整篇文章里我个人最喜欢的一部分,一个快被埋掉的故事。
上世纪80年代,美国有一对夫妇,James和Janet Baker,创立了一家叫Dragon Systems的公司,死磕语音识别。他们的思路在当时非常叛逆:别管什么语法语义,直接用机器学习,把语音映射成最匹配的文字,纯预测。
1997年,他们发布了Dragon NaturallySpeaking,当时第一个能识别连续自然语音的软件,准确率接近95%。
阿西莫格鲁为什么对这段历史这么熟?因为他就是第一批用户。1997年他两只手臂劳损,打不了字,全靠这个软件续命。他的原话是,哪怕当时的处理器慢得要死,那玩意儿用起来也像魔法。
按正常的剧本,接下来应该是技术狂飙,语音识别统治世界。
结果2000年,Dragon被一家叫Lernout & Hauspie的比利时公司收购。几个月后,这家公司直接破产,联合创始人后来因为公司欺诈被判有罪。接着ScanSoft低价抄底,改名叫Nuance,把消费级产品晾在一边,专心做医疗和企业生意。2022年,微软收购了Nuance,延续了同样的路线。
最后的结局是:今天PC上的语音识别,只比2000年好那么一丁点。
底层技术明明一路狂飙,消费者却空等了二十多年。
这个故事还藏着两个彩蛋。第一,基础设施的突破,得配上对路的应用、对的渠道都还没有。第二,Dragon 16发布的时候宣称99%的准确率,可那只是理想条件。剩下的1%,足以改变一句话的意思,让你把每封邮件从头到尾校对一遍,去捞那些藏得很深的口音错字。
99%,听起来高得吓人。可一旦摊到真实世界的最后一公里,往往还是不够用。
这个逻辑套到AI自动化上,也说得通。全自动意味着AI要接管一个职业里的每一个任务,包括高风险的判断和人与人的交道。现在的AI离这个状态,距离还不小。
五. 人和机器,到底谁该像谁?
讲完了故事,阿西莫格鲁抛出了全文最关键的一个观点:现在的行业路线,从根上可能就跑偏了。因为我们在干一件事,强迫AI去模仿人类智能。
而这两种智能,差别大到有点像两个物种。
人类是怎么学习的?看几个例子,形成一个假设,在脑子里模拟各种可能,然后跑到真实世界里试错。小孩基本都是这么学的。这种学习还天生带着社会性,你会盯着那些你觉得更懂的人,看人家怎么做。人类甚至可以说是用整个身体在思考的,大脑、神经、感官、肠胃,都在参与推理。
最有意思的是他对"幻觉"的翻案。人类的幻觉,在他看来接近一种天赋:我们脑补出一堆不存在的世界,再快速筛掉不靠谱的,留下值得追的。
AI几乎整个反过来。它从海量数据里学习,擅长在巨大的语料里抓模式,一种推理一旦学会,抽象场景具体场景随便用。但它缺少实时的社会学习,它幻觉起来基本就是灾难,因为它没有人类那套筛子。
所以他的看法是,两样东西差别这么大的时候,硬让一个去模仿另一个,多半是条笨路。
他举了个很妙的例子,乔布斯和沃兹尼亚克。乔布斯要是天天想着取代沃兹的工程能力,沃兹要是瞧不上乔布斯的设计营销天赋,大概就不会有后来的Mac。这俩人成事,靠的是两种完全不同的能力焊在一起。人和AI,或许也该是这么个关系。
其实这条路,65年前就有人指出来了。1960年,"互联网祖父"利克莱德写过一句话:人脑和计算机将紧紧耦合在一起,这个伙伴关系将以人脑从未有过的方式思考,以今天的机器从未有过的方式处理信息。
路线图早就画好了,结果行业绕了一个甲子的大圈。
阿西莫格鲁给的方向,起了个名字,叫pro-worker AI,支持劳动者的AI。别追全面自动化,去造让劳动者更强的工具。
他举了教育的例子。现在的教育AI,大多琢磨着怎么接管老师的活。可全自动教学遥遥无期,思路一换,天地立刻宽了不少:AI可以识别出每个学生在哪些知识点上卡壳,然后建议老师把班级拆成小组,针对每个组的弱点精准补课。个性化教育过去贵得离谱,只有少数家庭玩得起,AI有机会把它拉成白菜价。
他还透露,自己的团队已经做了原型,正在评估。用的东西倒是不神秘,一个中等规模的语言模型,喂上课程内容和优秀教师处理各种学生问题的案例。按他的说法,这在现有技术能力之内。
六. 那为什么行业还在往死里卷自动化?
既然这条路又宽又亮,为什么走的人少?他列了四种力量,前三个是经济层面的,最后一个是意识形态。
第一,商业模式。大科技公司的钱,主要来自卖企业软件和数字广告,这套生意里很少有"增强劳动者"这个选项。
第二,市场集中。七大科技巨头,Alphabet、亚马逊、苹果、Meta、微软、英伟达、特斯拉,占了纳斯达克60%的市值。创业公司就算冒了头,常见的归宿还是被收购。于是赢到最后的,往往还是同一套商业模式。
第三,他起了个很形象的名字,螺母和螺栓问题。螺母没有螺栓没用,螺栓没有螺母也没用。企业认定科技公司只会卖自动化工具,于是按自动化做规划。科技公司认定企业只买自动化工具,于是只开发自动化。两边互相锁定,谁都很难先挪窝。
第四,AGI执念。这个行业被"像人一样的机器"这个念头影响了七十多年,源头能一直追到图灵1950年那篇论文,开篇就是著名的模仿游戏。再加上科幻小说和电影几十年的浇灌,"达到人类水平"差不多成了硅谷所有应用的及格线。不少技术领袖打心底里觉得,人这种生物,会犯错,不可靠。
顺着这个诊断,他开了四味药:劳动和资本对称征税,现在美国劳动收入的边际税率超过25%,资本收入却接近零,在他看来等于政府在掏钱补贴企业用机器替人;政府出资搞pro-worker AI的示范项目,把可行性做出来给大家看;反垄断法该更新了,更该真的执行,还可以考虑开征数字广告税;最后,建立数据市场,让顶尖专家的高质量知识能控制、能定价、能卖钱。
七. 尾声
最后,说两个小故事。
第一个故事,还是1987年。索洛说出那句"计算机无处不在,唯独不在生产率统计里"的时候,不少人觉得他在泼冷水。后来的事我们都知道了,90年代中后期,美国生产率真的起飞了,互联网革命兑现了承诺。只比乐观派预期的,晚了十几年。
技术很少爽约,它只是喜欢迟到。
第二个故事,1950年。图灵在那篇开创性论文的开头,写下了模仿游戏:如果一台机器聊到你分不清它是不是人,我们能不能说它会思考?这个问题太迷人了,迷人到后来七十多年,大半个学科都在围着"像不像人"打转。
一个好问题,能开辟一个时代。它也可能悄悄变成一个时代的牢笼。
再说回微软。有个细节很耐嚼,媒体The Decoder在报道里不咸不淡地补了一刀:这套论点对微软来说,实在太顺手了。AI慢慢渗透,嵌进Office,嵌进Windows,一年一年稳稳收订阅费,这可比赌一个全面自动化的疯狂未来,舒服多了。
发表不等于背书。但在这个时间点,给这样一篇文章这么大的排面,微软心里的小算盘,打得估计也挺响。
所以这篇文章到底意味着什么?
我的感受是这样的。它可能对,也可能错得离谱,阿西莫格鲁自己的态度就是,模型的进化速度很难预测。但它至少说明了一件事:在多数人都在喊"更快、更大、更像人"的洪流里,还有人在认真地问另一个问题。
我们想要的AI,到底长什么样?
是给每个人发一个更强的外挂,还是造一个把人踢下桌的替身?
本文来自微信公众号“大数据文摘”,36氪经授权发布。
















