世界模型新突破:偷懒率下降85.7%
世界模型预测机器人操作过程时,能否保持目标的物理一致性,避免无故复制、消失或形变?
目前的主流方法,是以预训练视频生成模型为基础,在机器人操作数据上进行监督微调(SFT),根据初始观测、任务指令等条件生成后续交互视频。训练主要通过视觉重建,使生成结果与示范视频相匹配。
然而,这类训练的过程监督仍存在局限:目标区域较小,局部误差容易被全局重建损失稀释;同时,视觉重建主要约束画面与示范视频的相似性,并未显式要求相邻帧中的目标表征对应同一物理实例。
为此,招商局集团先进技术研究院联合南洋理工大学(NTU)提出了一个物理演化监督框架EVEWorld,通过实例引导恢复(IGR)与时序实例对齐(TIA),分别强化操作目标的实例一致性与跨帧一致性。
论文链接:https://arxiv.org/pdf/2610.03374
他们将操作过程中无依据的目标复制或消失定义为Model Laziness(模型偷懒),并提出了“模型偷懒率”(MLR),旨在衡量这类持续性数量异常在可评估生成视频中的发生比例。
结果显示,在 WorldArena 2.0 Track 1 上,基于 FlowWAM 的 SupervisionWM 获得 70.17 分,JEPA Similarity 排名第 6,综合排名第 17;在 DreamGenBench 上,EVEWorld 相较普通 SFT,将 MLR 从 11.11% 降至 1.59%,相对下降 85.7%;整体 Gemini-IF 相对提高 13.6%,在减少目标数量异常的同时,改善了指令遵循。
这项工作将操作目标的演化过程纳入世界模型后训练监督,为提升目标一致性与交互预测的可靠性提供了实验依据。
一、研究方法
EVEWorld 通过两个模块提升操作目标的物理一致性:实例引导恢复(IGR)强化实例一致性,时序实例对齐(TIA)强化跨帧一致性。MLR 用于衡量生成视频中持续性的目标数量异常。
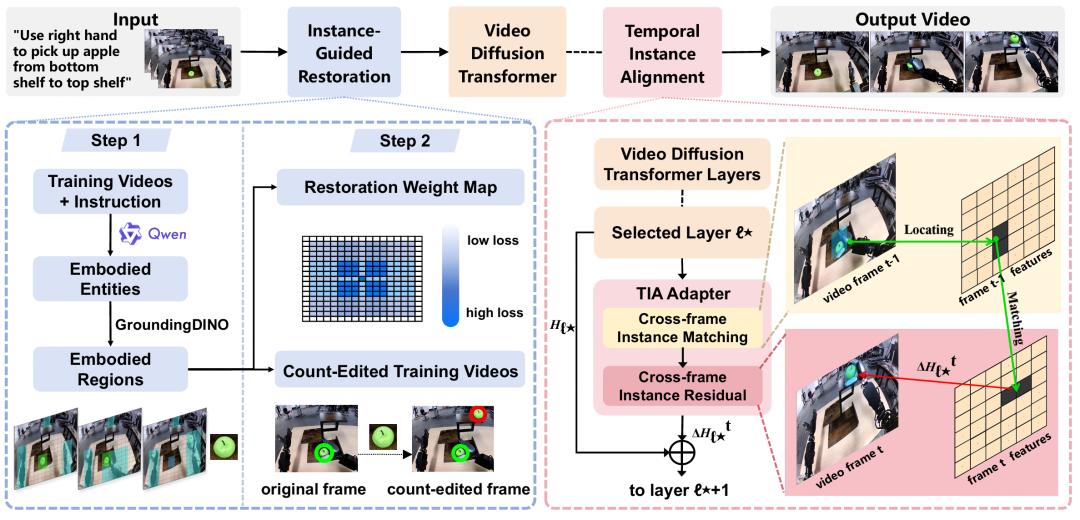
图|EVEWorld 整体框架。IGR 构造数量扰动训练对,并强化恢复相关区域的重建监督;TIA 在选定的 Transformer 层执行跨帧实例匹配与特征传输。
1.IGR:恢复正确的目标数量
IGR 的核心是先构造数量异常,再训练模型恢复原始视频。训练过程分为:
- 定位目标。根据任务指令,找到示范视频中的操作对象。
- 构造扰动。复制目标并放到有效位置,得到多出一个目标实例的训练数据。
- 训练恢复。以扰动视频为输入,原始干净视频为恢复目标,让模型学习纠正额外实例。
训练时,恢复相关区域的相对重建权重为普通区域的 3 倍,以增强局部纠错信号。无法构造有效扰动的样本,则使用原始干净视频进行训练。
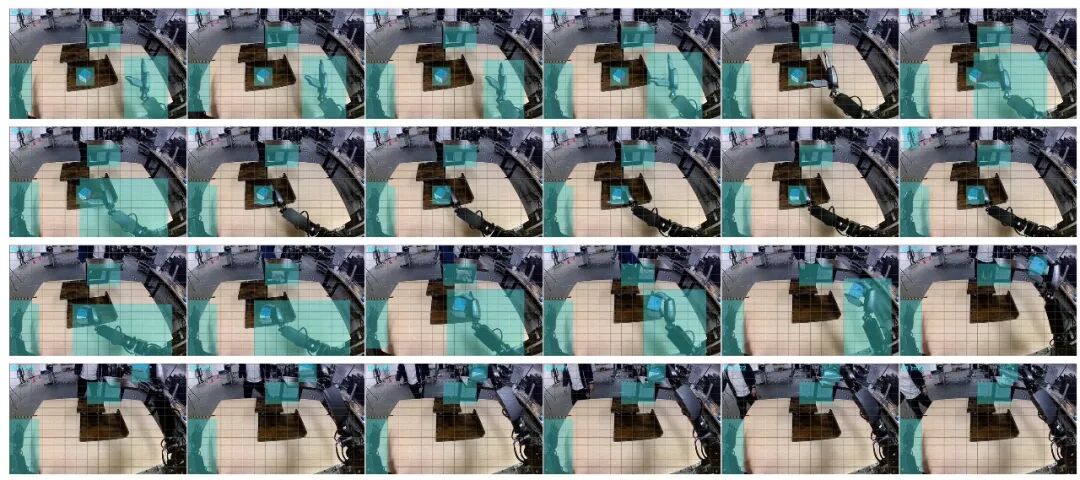
图|IGR 区域加权示例。
2.TIA:约束目标的跨帧一致性
目标数量正确时,物体仍可能发生形变、身份漂移或突然位移。为此,他们在视频扩散 Transformer 的选定层接入 TIA 模块,通过相邻帧特征的匹配与传输,约束同一目标的跨帧演化:
- 特征匹配。在下一帧的邻近区域中,寻找与上一帧相似的特征。
- 特征传输。根据匹配关系,将上一帧的特征信息传递到当前帧。
- 更新与监督。用传递的信息更新当前帧特征,并在训练时监督同一目标在相邻帧中的对应关系。
TIA 训练所需的目标定位在离线阶段完成。在推理阶段,TIA 直接根据模型隐藏特征完成匹配与传输。
3.MLR:衡量持续性的数量异常
MLR 以初始观测中的目标数量为参照,判断生成视频是否出现持续性的数量偏离。评估分为三步:
1.统计数量。在初始帧和后续采样时刻识别目标,比较实例数量。
2.检查遮挡。对目标少计数检查机器人遮挡证据,排除遮挡所支持的少计数;目标多计数则保留为异常证据。
3.判断持续性。如果连续多个采样时刻的数量均偏离初始值,则将该视频记为异常。
最后,统计异常视频占可评估视频的比例,得到 MLR。
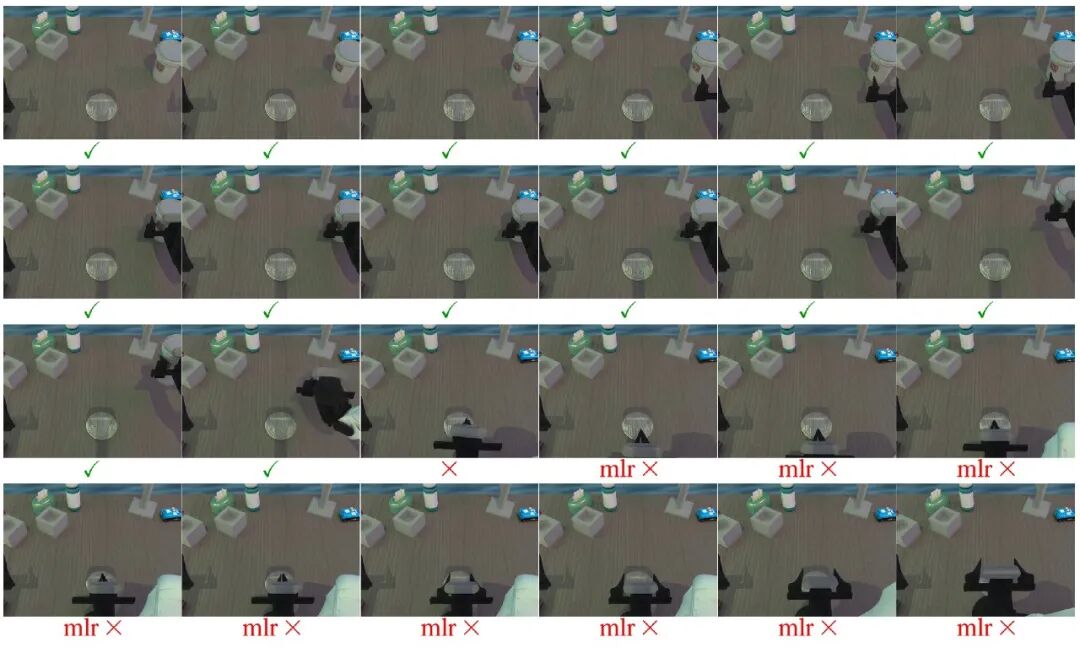
图|MLR 评估示例。
二、实验结果
他们在DreamGenBench上测试了 EVEWorld 的目标实例一致性与指令遵循表现,并考察了模型面对未见环境、对象和行为时的泛化能力。通过组件消融与复制扰动恢复测试,他们进一步分析了 IGR、TIA 各自的作用,以及两者结合后的效果。
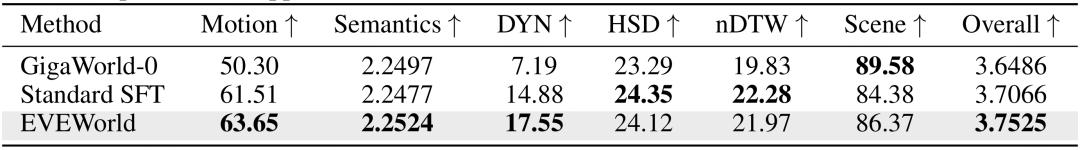
同时,实验还覆盖了不同场景、机器人形态、训练数据和模型骨干,包括在 WorldArena 1.0 上开展零样本迁移评估,在不同分布的 AgiBot 数据进行后训练,并在 EWMBench 上评估运动质量与综合表现;随后将方法迁移至 FlowWAM,在 RoboTwin 和 WorldArena 2.0 上检验跨骨干表现。此外,PBench Robot 实验通过不同生成时长和随机种子的成对比较,证明了性能提升的稳定性。
1.模型“偷懒”减少,整体指令遵循同步改善
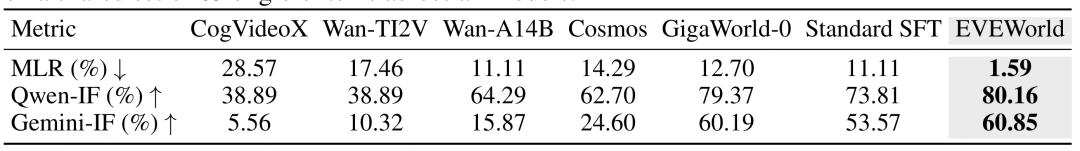
在 DreamGenBench 中,相较普通 SFT,MLR相对下降 85.7%。同时,整体 Qwen-IF 和 Gemini-IF 评分提高 6.35 和 7.28 个百分点。
他们还分别检查了模型在未见环境、对象和行为上的表现:
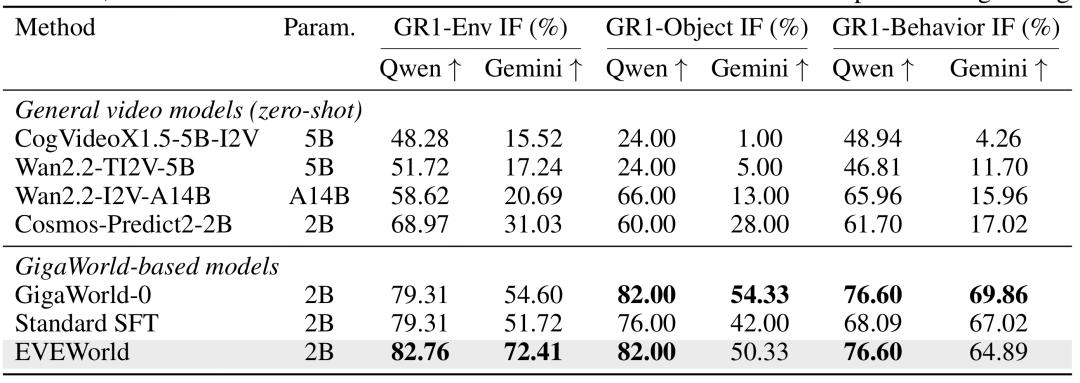
细分结果显示,EVEWorld 在未见环境和对象上的 Gemini-IF 分别提高 20.69 和 8.33 个百分点,未见行为上的 Qwen-IF 提高8.51 个百分点。整体两项指令遵循评分均得到提升。
2.IGR 与 TIA 如何配合
在消融实验中,他们分别测试仅 IGR、仅 TIA 和完整组合,并与普通 SFT 比较,检查两个模块各自带来的变化。
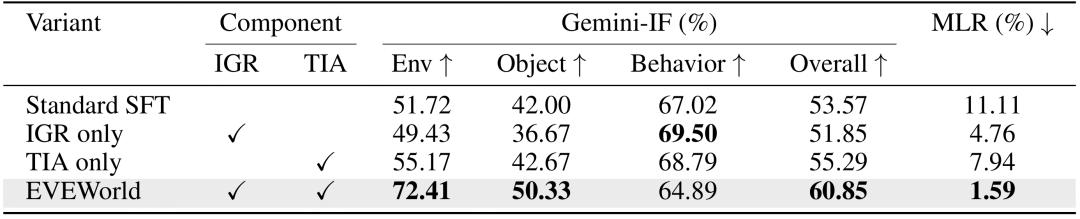
仅使用 IGR 或 TIA 时,MLR 分别为4.76%和7.94%;联合使用后降至1.59%,整体 Gemini-IF 达到60.85%,两项指标均优于单独使用,体现了两项监督的互补作用。
3.场景与训练数据泛化
在WorldArena 1.0上,他们检查了模型面对不同场景和机器人形态时的表现。
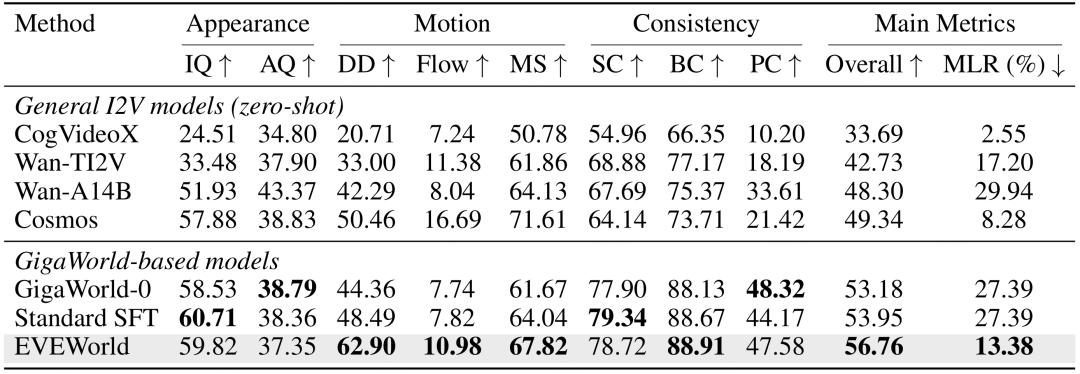
在 157 条共享可评估样本中,普通 SFT 有 43 条视频出现持续性数量异常,EVEWorld 减少至 21 条。MLR 相对下降约 51.1%,说明目标数量一致性的改善能够延伸至不同交互环境。
随后,他们换用 AgiBot 操作数据进行后训练,并在 EWMBench 上评估。相同数据和优化预算下,EVEWorld 的运动评分相对提高 3.48%。在 PBench Robot 上,两个生成时长与三组随机种子构成的六组成对实验均取得正向增益,进一步支持了性能提升的稳定性。
4.模型骨干泛化
他们进一步将演化监督迁移到FlowWAM,检查方法能否用于光流条件的世界模型。
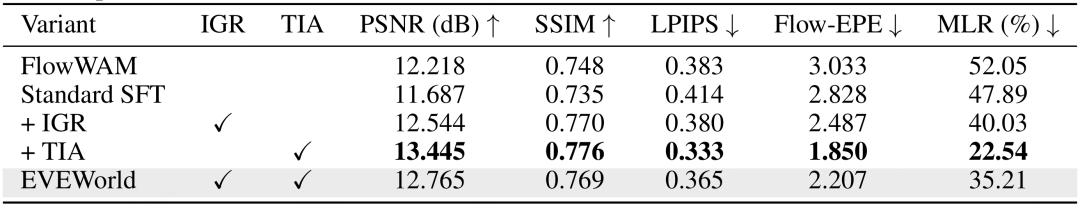
在 RoboTwin 上,完整 EVEWorld 将普通 SFT 的 MLR从 47.89% 降至 35.21%,视觉重建指标也得到改善。其中,仅使用 TIA 的 MLR 为 22.54%,表现更好,说明组件收益与具体骨干有关。在固定的评估子集上,六个训练检查点的 PSNR 和 SSIM 均高于对应对照。
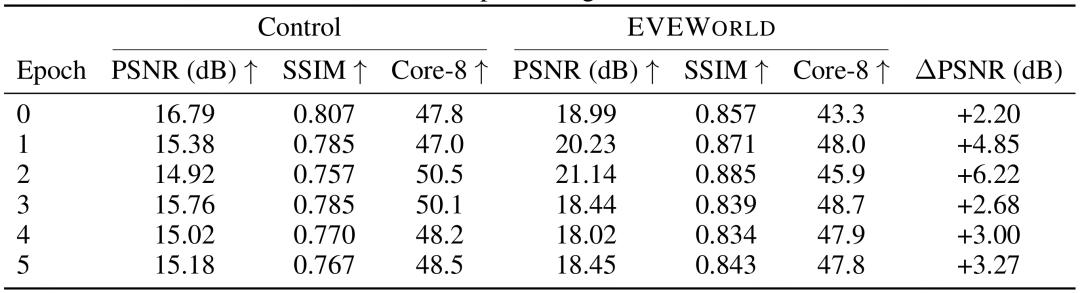
EVEWorld 的结果表明,如何监督操作目标的演化,是影响世界模型交互预测可靠性的一个重要因素。目标数量的物理一致性应成为训练与评估中重点关注的内容。
该方法的局限主要源于其局部的成对监督,这种监督没有显式地刻画长程的状态依赖关系和复杂的多物体交互。
下一步,他们将扩展EVEWorld的演化监督形式,覆盖长程状态依赖与复杂多对象交互,检验模型能否在更长、更复杂的机器人操作过程中持续保持一致性。
本文来自微信公众号“学术头条”(ID:SciTouTiao),作者:学术头条,36氪经授权发布。
















