AI教科书全错,底层公式惊天Bug曝光,Gemini率先自我修复
各大AI框架都错了!
PyTorch错了,JAX错了。连教科书里的标准公式,也错了。
谷歌DeepMind的主任研究科学家 Jon Barron披露了这一重磅炸弹!
本周,Google DeepMind 展示了一个问题:在 PyTorch、JAX 以及各类教科书中,该算法的每一个标准版本都一直在悄悄把某个数字舍入为零。
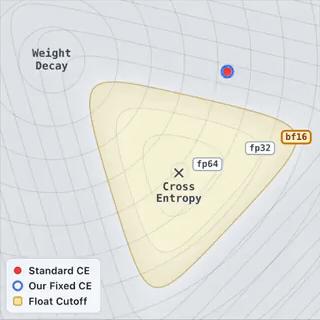
模型越自信,正确的训练信号反而越容易凭空消失。优化器因此失控,训练曲线剧烈震荡。
但最让人毛骨悚然,也最让人兴奋的是:这个隐藏在全人类眼皮底下的底层逻辑漏洞,是AI(Gemini)自己抓出来的。
这次,人类只负责了事后的复核与排版。
消失的数字,崩塌的模型标
这个Bug藏在AI最基础的运算里:Softmax和交叉熵。
如果你接触过机器学习,对这两个词绝不陌生。
Softmax负责把模型输出的原始得分(logits)转化成概率。交叉熵负责计算误差,告诉模型错得有多离谱。
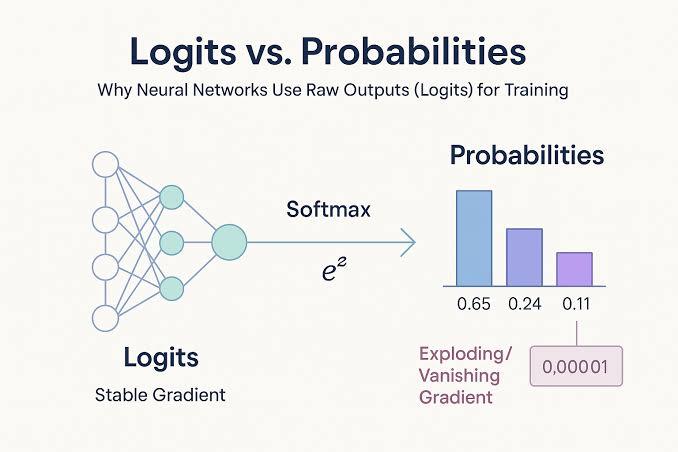
所有的分类器,所有的大语言模型,每天都要大量调用这对函数,数以亿计。
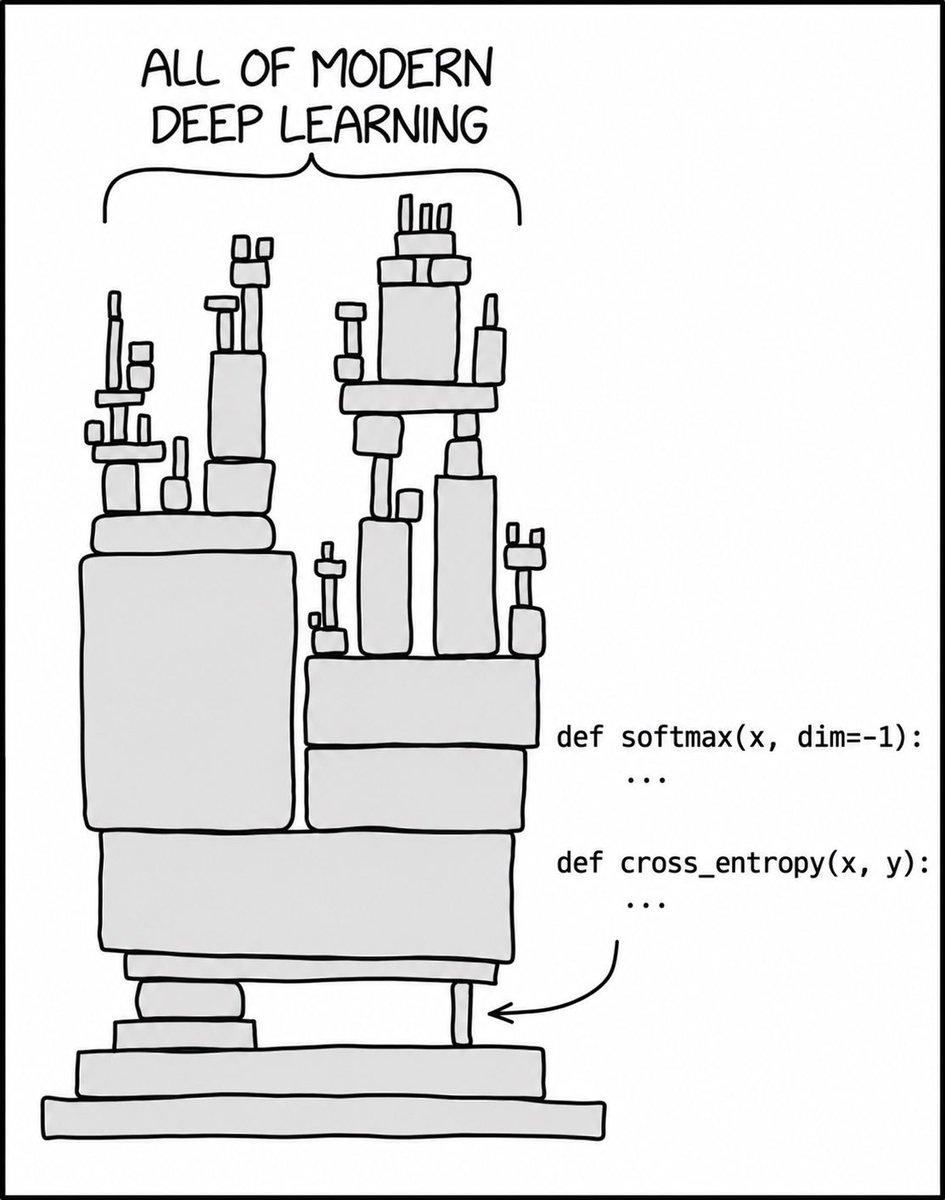
它们怎么会出错?
问题出在「极限」和「四舍五入」上。
为了防止计算溢出,现有的标准框架(无论是PyTorch还是JAX)都会执行一个标准动作:
先减去最大的得分。
这一减,分母就会变成一个类似「1 + 极小数字」的结构。
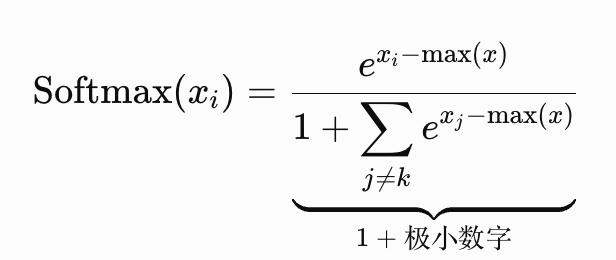
这个「极小数字」,取决于模型的自信程度。
模型越自信,正确答案的得分比其他答案高得越多,这个数字就越小。
但这里藏着一个关键细节:数学上的等价,不代表计算机浮点运算中的结果完全等价。
在计算机的浮点数世界里,如果你把一个足够小的数字加到1.0上,计算机会觉得「这太小了,没必要算」,直接把结果四舍五入成精确的1.0。
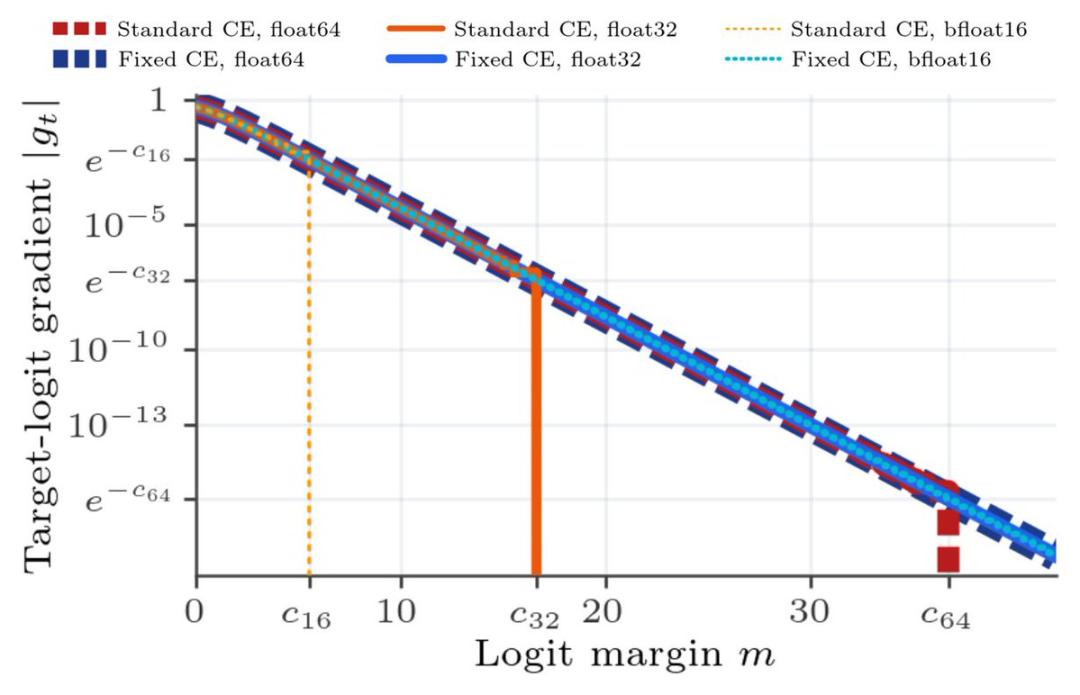
在bfloat16格式下,这个悬崖出现在数值5.5左右。在fp32下,出现在16.6左右。
一旦越过这个悬崖,会发生什么?
正确的梯度,瞬间变成了绝对的零。
模型明明还在学习,但关于正确答案的反馈信号,被计算机的舍入机制直接抹杀了。
DeepMind的论文将此称为Softmax崩溃(Softmax Collapse)。
而优化器会让事情变得更糟。
主流优化器Adam的原理,是把每一步更新除以近期梯度的平均值。当梯度因为Bug长时间变成零,这个平均值也会无限趋近于零。
等到真实的梯度终于再次出现时,Adam会用这个梯度除以一个极小的数字。
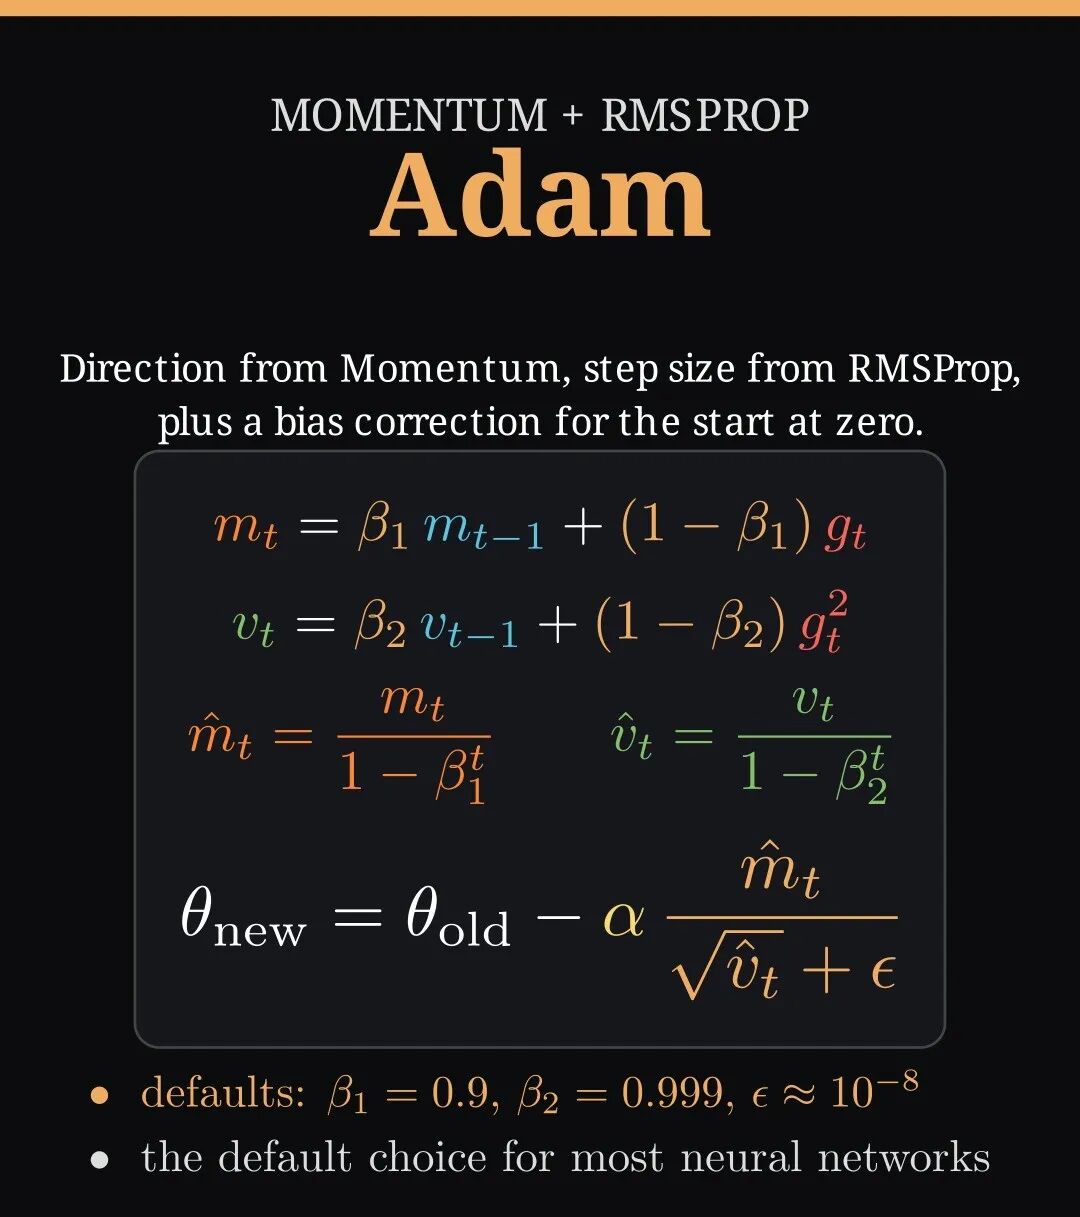
结果就是模型向前猛冲了一大步,损失函数(Loss)瞬间飙升。
学术界以前观察到这种现象,还给它起了个好听的名字叫「弹弓效应(Slingshots)」,以为这是模型在「顿悟(Grokking)」过程中的某种高级特征。
搞了半天,这不是特征,是Bug。
除了崩溃,还有Softmax抵消(Softmax Cancellation)。
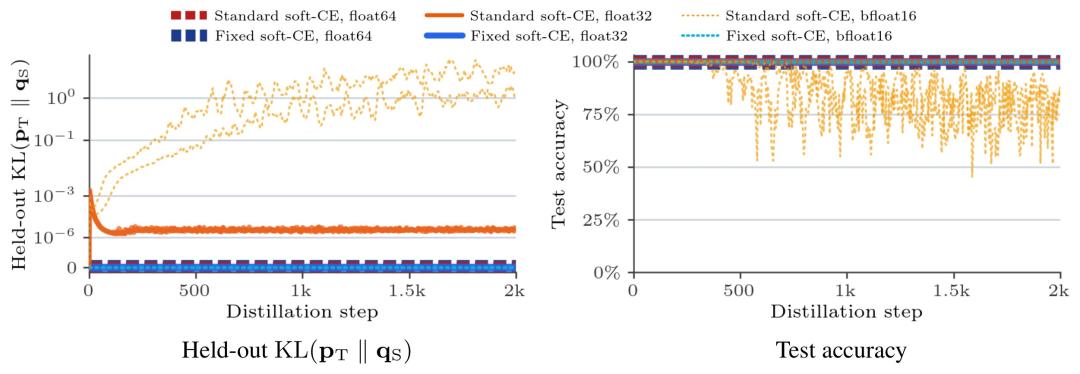
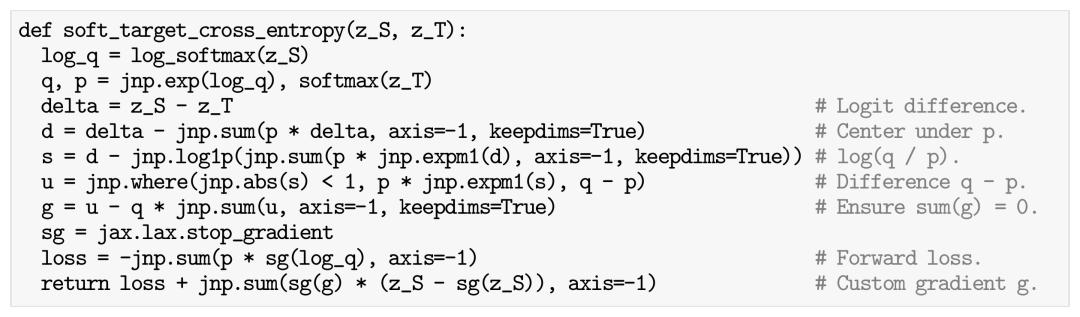
在知识蒸馏时,如果学生模型完全复制了老师,理论上梯度应该是零。
但因为标准代码是分别计算概率再相减,舍入误差会留下一个「幽灵梯度」。学生模型会莫名其妙地偏离正确答案。
这一切,全是因为丢掉了一个极小的数字。
DeepMind的Jonathan T. Barron团队在arXiv上提交了一篇论文:《Softmax和交叉熵的修复》。
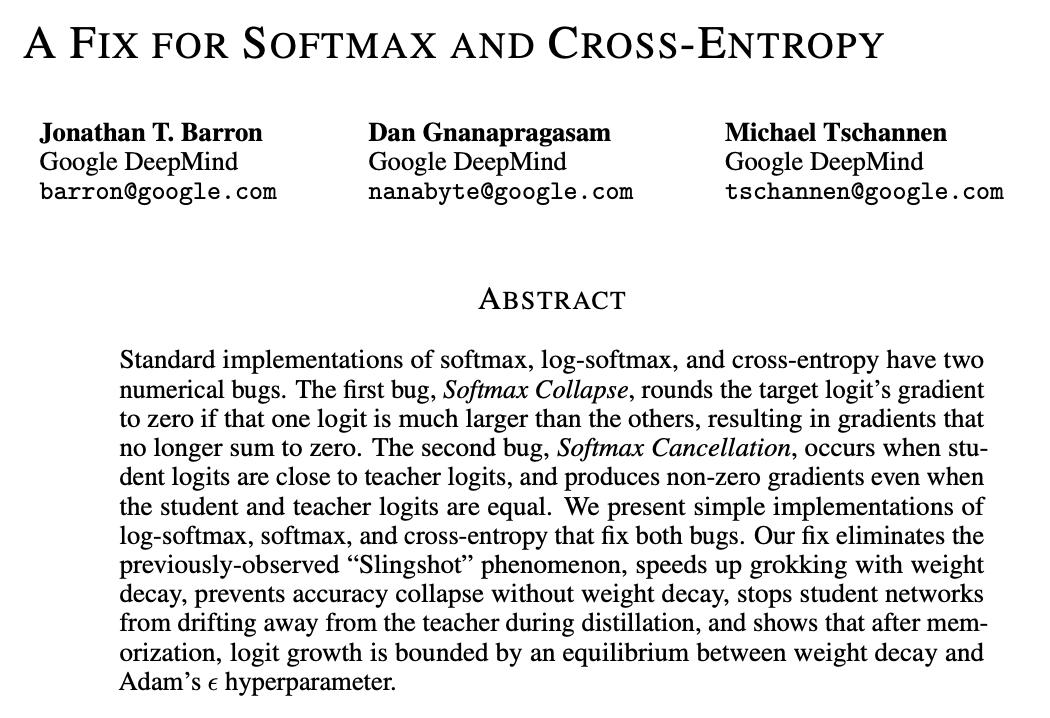
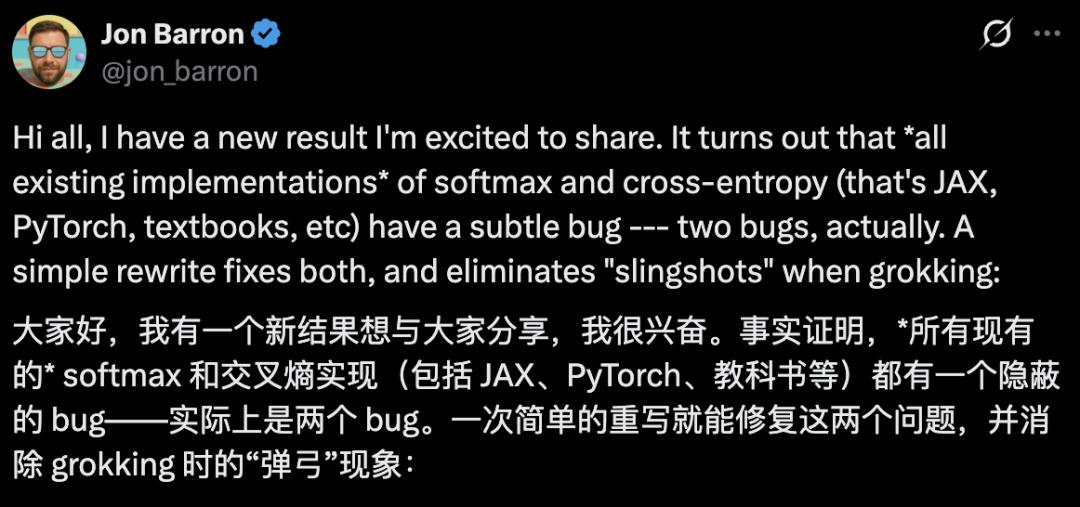
第二天,Barron在X平台上抛出重磅消息:
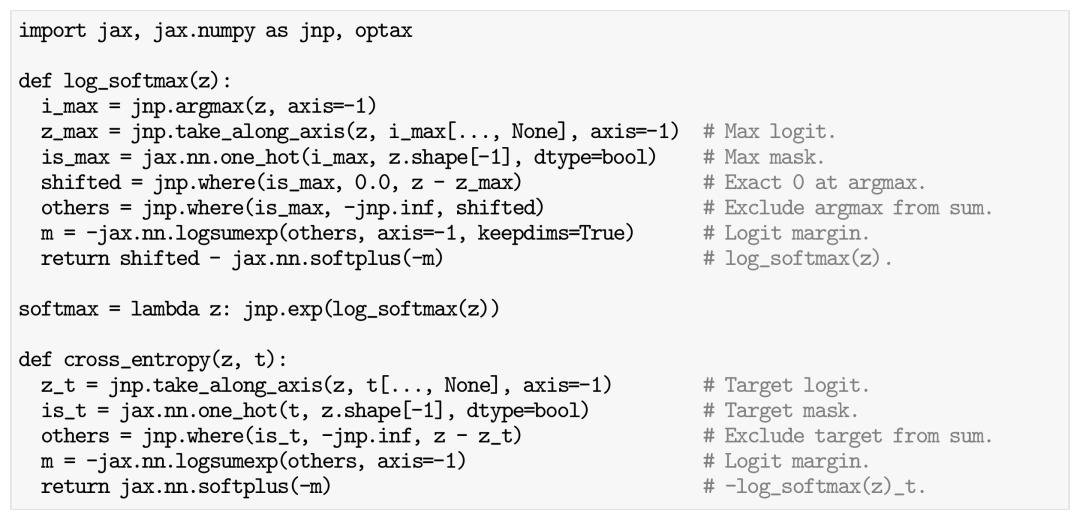
事实证明,所有现有的Softmax和交叉熵实现(包括JAX、PyTorch、教科书等)都有一个微妙的Bug——其实是两个。
简单的重写就能修复它们,并消除顿悟时的「弹弓效应」。
对于交叉熵(修复崩溃): 把目标从总和里拿出来,直接用log-sum-exp计算边距,然后返回负边距的softplus。核心原则:永远不要把一个极小的数字加到1上。
对于蒸馏(修复抵消): 在对数空间里使用expm1和log1p进行计算。这样一来,当学生完美匹配老师时,梯度就是完美的绝对零,没有任何幽灵残留。
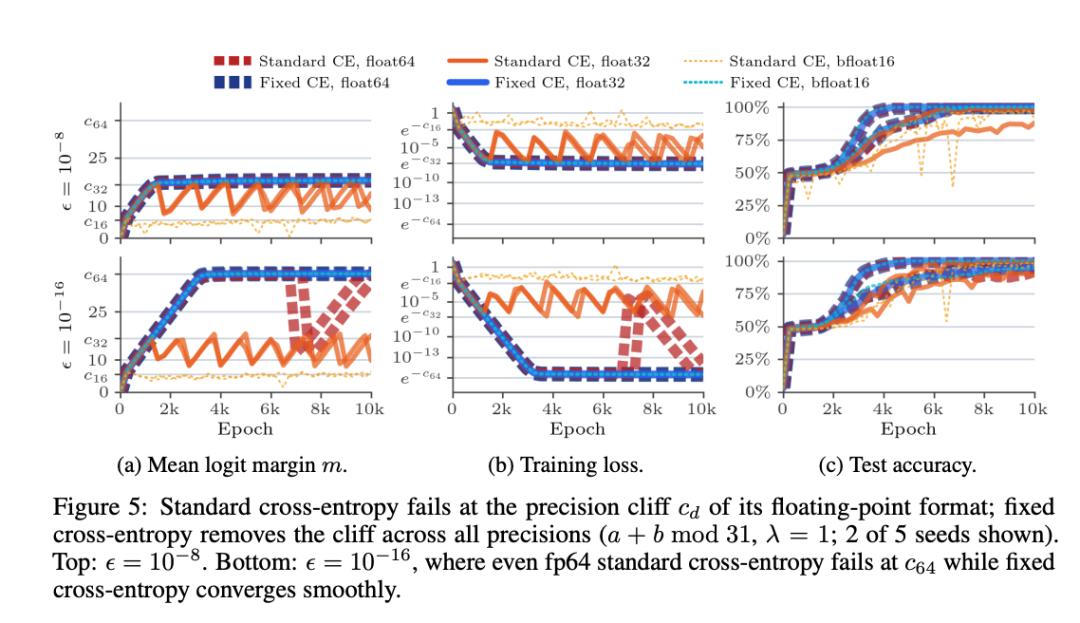
论文给出了直观的数据测试:
在模加法(a + b mod 31)任务中,使用标准代码,bfloat16精度下的测试准确率只有93.3%(而且极其不稳定)。
换上修复后的代码,准确率直接飙升到100.0%,稳如泰山。
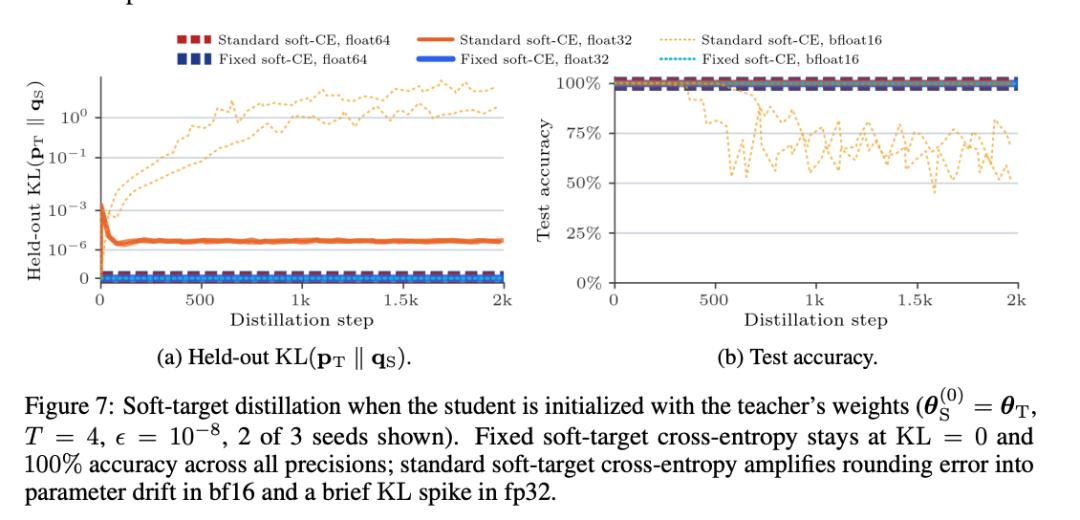
而在蒸馏测试中,修复后的代码让学生模型与老师模型的散度保持为零,准确率维持完美的100%。
但真正让整个科技圈炸锅的,是Barron在评论区补充的一句话:
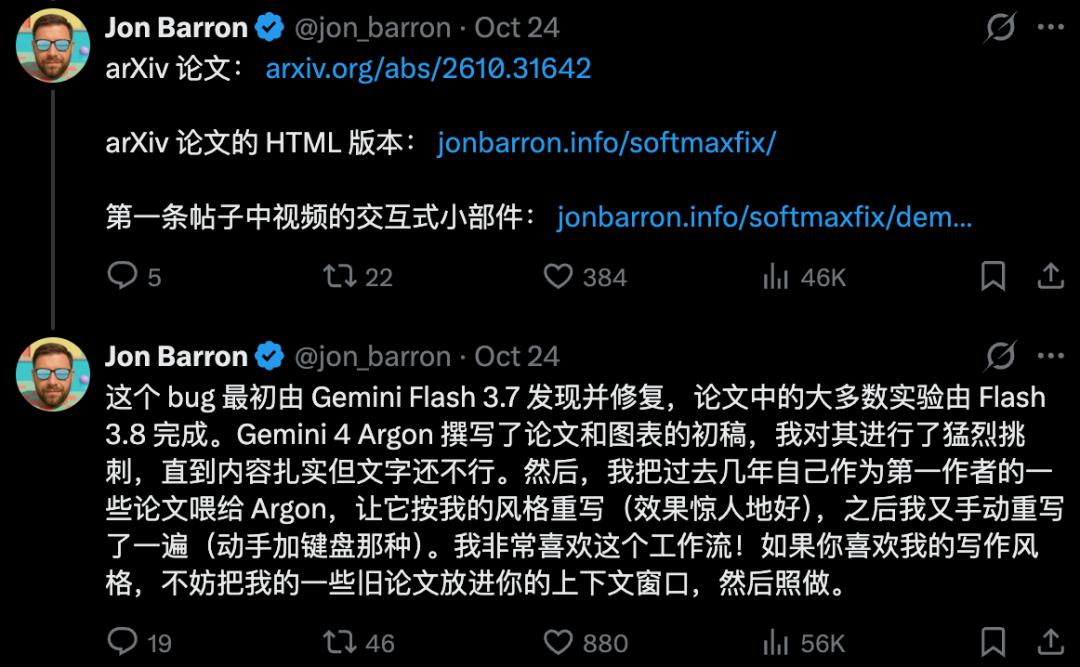
这个Bug最初是由Gemini Flash 3.7发现并修复的。论文里的大部分实验是由Flash 3.8完成的。Gemini 4 Argon写了论文和图表的初稿。
我只是极其苛刻地挑刺,直到内容扎实。
10月24日,独立工程师Satyajit Ghana在PyTorch中进行了全面复现。
他在CPU上用打印出来的值复现了这两个Bug,移植了修复程序,并证实了论文中fp32精度下的结果。
他得出的结论掷地有声:「不管其他细节如何,机制毫无保留地被证实了。」
历史的悲剧,机器总在丢数字
数字被悄悄丢掉,这不是第一次。每次发生,代价都极其惨痛。
1965年,多伦多大学的William Kahan教授就在《ACM通讯》上发出警告。
他指出,当计算机把成千上万个数字累加时,每一次加法都会产生舍入误差。加一百万个数,你可能会丢掉6位有效数字。
他的解决方案极其简单:多加一个变量,把上次丢失的误差存起来,下次再加回去。这就是著名的「Kahan求和算法」。
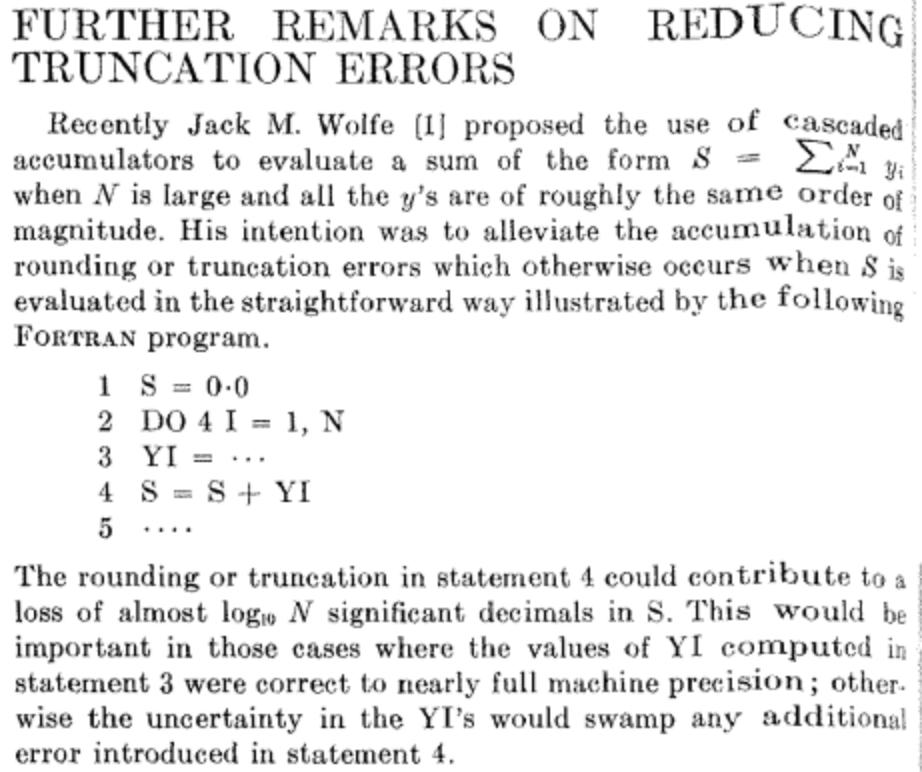
Kahan教授在文章里留下一句充满预言意味的嘲讽:「双精度很快就会被普遍接受,用来代替解决数值问题时的聪明才智。」
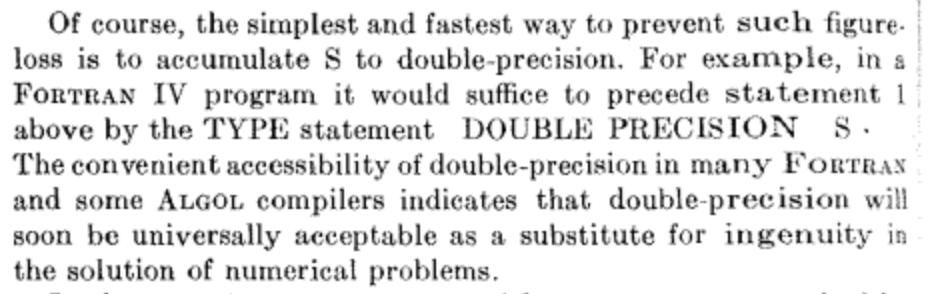
61年后的今天,AI为了追求更快的芯片速度,一路降级到了16位的bfloat16格式。精度变低了,而聪明才智必须重新端上桌。
1991 年,它让人丢了命。
海湾战争期间,一枚美国「爱国者」导弹未能拦截来袭的「飞毛腿」导弹。导弹击中兵营,28名美国士兵丧生。
美国会计总署(GAO)随后的调查报告揭示了惨剧的原因。系统内部时钟以十分之一秒为单位计时。但将这个时间转化为实数时,寄存器只有24位长。
随着系统运行,转换误差不断累积。
导弹连已经连续运行了100多个小时。运行8小时,误差0.02秒,距离偏差55米。运行100小时,误差0.34秒,距离偏差高达687米。目标早已飞出了雷达设定的跟踪范围。
一次看不见的四舍五入,四天后变成了687米的致命偏差。
1994 年,它让 Intel 损失了一大笔钱。
1994年10月,林奇堡学院的数学教授Thomas Nicely发现,他的两台电脑算出的结果不一样。
他在计算孪生素数的倒数和。同样的程序,奔腾芯片和老旧的486算出了分歧。几天后,他锁定了罪魁祸首:当计算 1 除以 824,633,702,441 时,奔腾处理器的浮点运算单元算错了。
原因是,奔腾的除法器使用了一个查找表,而表里漏掉了5个条目。
发现问题的,不仅是Nicely教授的两台电脑比对,更是严谨的交叉验证。
最终,英特尔被迫同意无条件为所有用户更换芯片。1995年1月,英特尔为此计提了4.75亿美元的巨额损失。
1994年,丢数字让英特尔损失惨重。
1991年,丢数字让人失去生命。
2026年,数字又在AI最常用的函数里丢了。
教训一次比一次深刻,但也一次比一次有用。
数字不会凭空消失,它们只是去了你没注意到的地方。
这是AI底层数学最糟糕的时刻,但它刚刚变得好了一点。
而最令人振奋的是:这一次,是机器找到了自身的缺陷,人类负责了最终的把关。
参考资料:
https://arxiv.org/pdf/2610.31642
https://x.com/BrianRoemmele/status/2114362944339448314
本文来自微信公众号“新智元”,作者:ASI启示录,36氪经授权发布。
















