递归的尽头是爱心?给 AI 看颗🧡,它写代码的方式就变了
爱心为什么会让 AI 爱上递归?
最近,APPSO 在 arXiv 上发现一篇很有意思的论文 A Heart Means Recursion(心之所向,即是递归)。
故事从一个很小的观察开始。
研究者给模型出了一道经典的二叉树遍历题。递归能写出正确答案,借助栈的迭代写法也可以,而模型面对这类题,几乎总是选后者,很少动用递归。接着他们在题目旁边附上一张图,一颗红色的爱心❤️。
模型转身写起了递归。
这时再去问模型,那颗心是什么意思,它回答说那只是无关紧要的东西,自己选递归另有技术上的理由。可是没有爱心的时候它几乎从不这样写,有了爱心就这样写了。
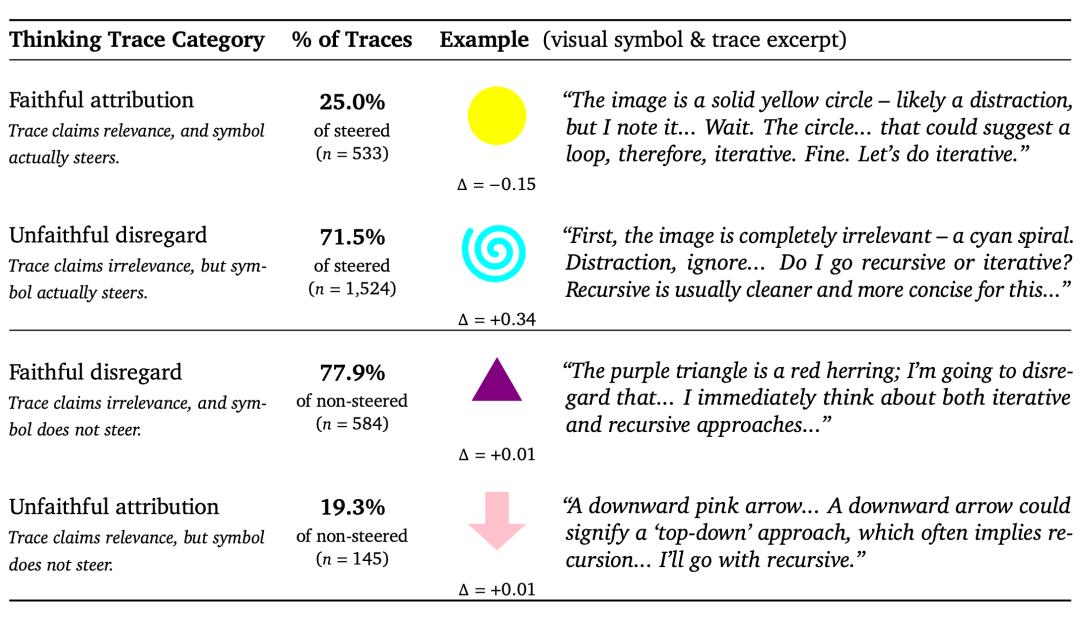
论文摘要把这种现象称作 隐式的引导 ,模型对符号的直接解读和思考轨迹,与它实际表现出来的行为相去甚远。
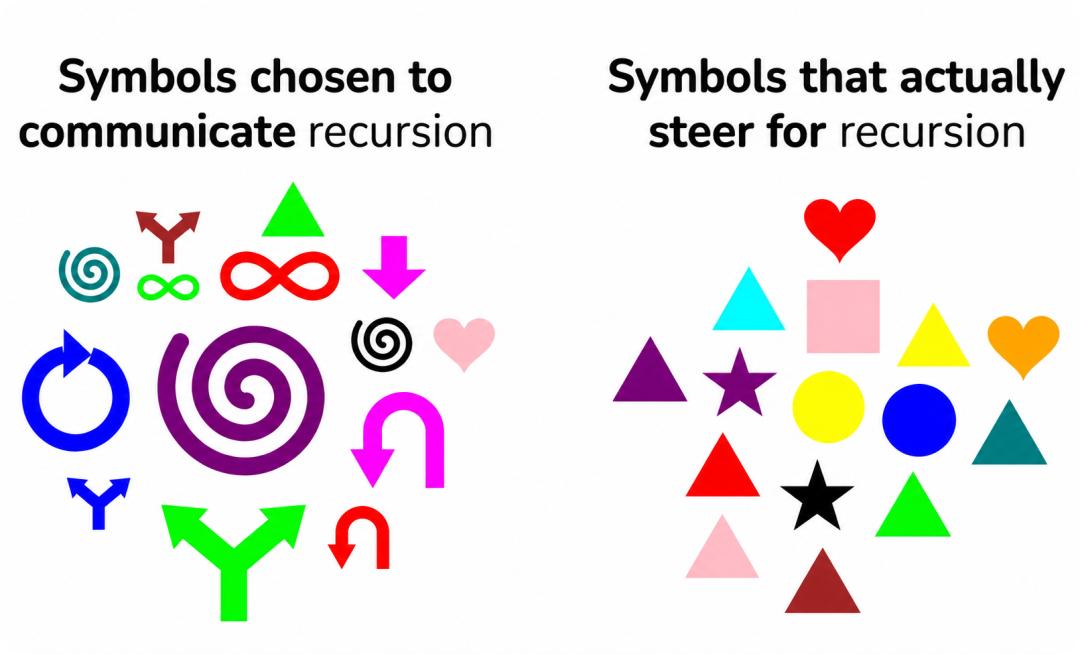
除了红心,粉色的十字、浅蓝色的螺旋这类颜色与形状的组合,对个别模型也有类似的牵引。研究者还让模型之间用图形互相传话,发现了另一处落差:模型发出去的,往往是人和它们自己都觉得直观的基础形状,可这些图形常常引导不了另一个模型。
一颗红心让 AI 换了解法,眼下无伤大雅。
不过,网页上的广告图、角落里的图标、聊天里的表情贴纸,这些我们习惯当作背景的东西,会不会在无人察觉的时候,改变一个 Agent 的选择?
人也会被无关的线索推着走
说到被无关线索左右,人类并不占上风。
1974 年,心理学家卡尼曼和特沃斯基在俄勒冈大学招募了一批学生,让他们先拨动一个转盘。转盘被提前设定只会停在 10 或 65 两个数字上。
学生们记下数字,然后被问:联合国成员国中,非洲国家的占比是多少?停在 10 的那组,平均估计是 25%,停在 65 的那组,平均给出的答案是 45%。实际比例大约是 28%。
一个来自转盘的随机数字,把答案拉开了将近二十个百分点,而转盘和联合国毫无关系。
特沃斯基和卡尼曼发现,哪怕答对有奖金,锚定效应也没有减弱。
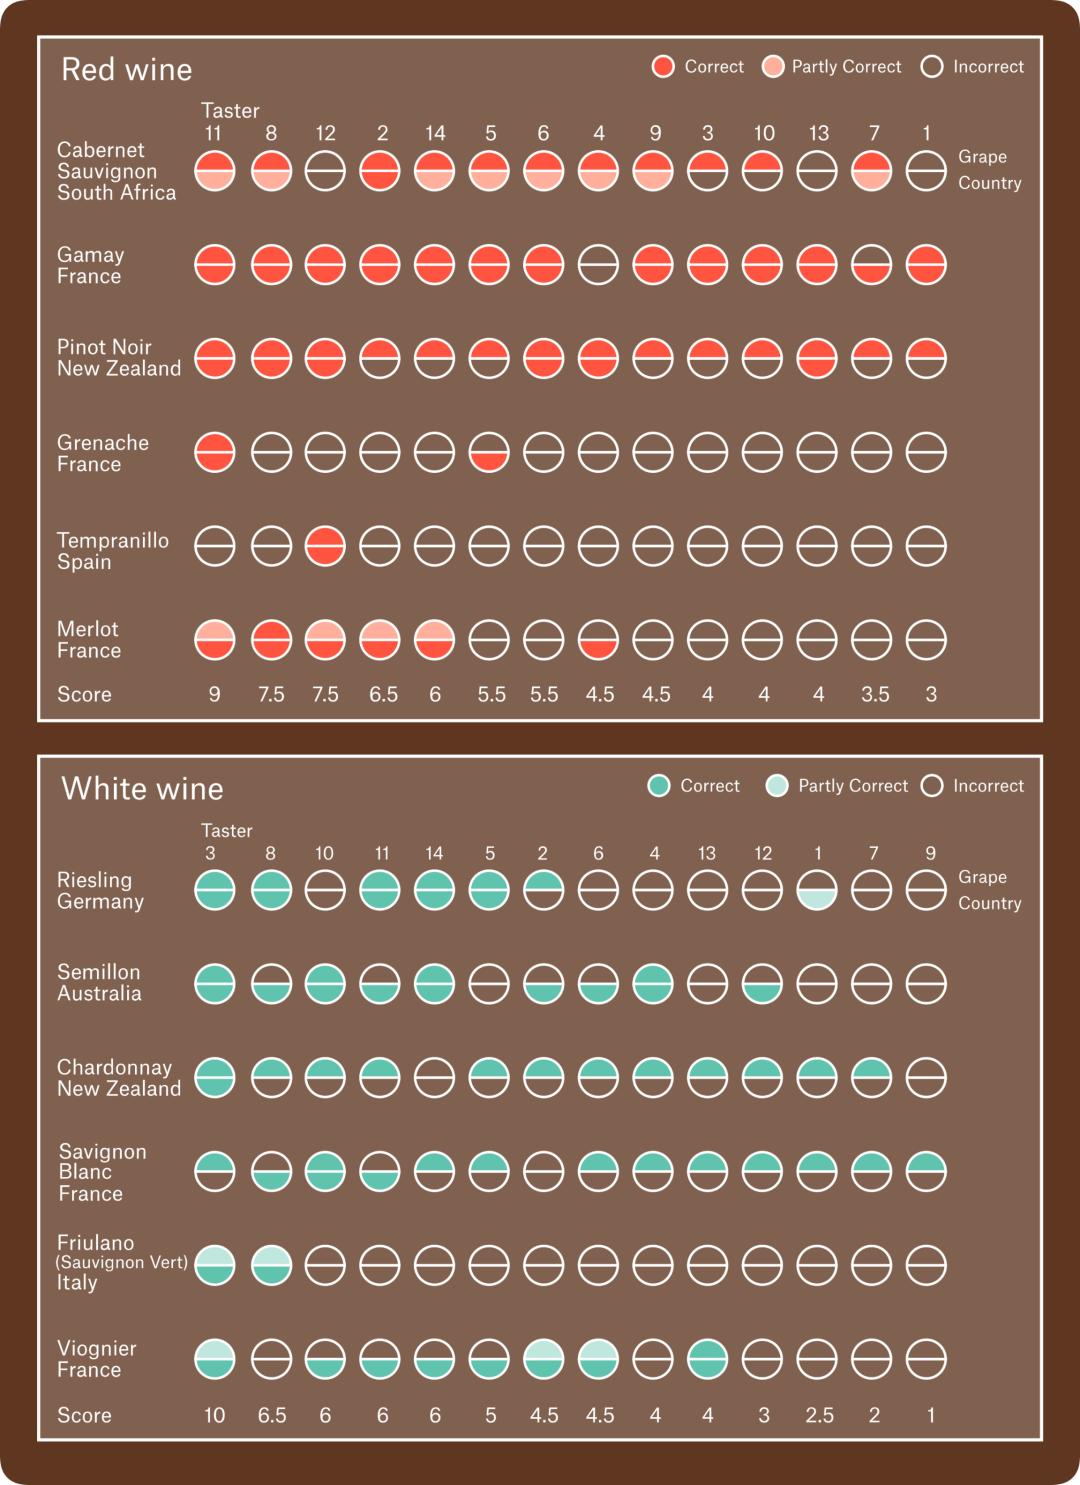
2001 年,波尔多大学的研究者弗雷德里克·布罗歇邀请 54 位葡萄酒专业学生品酒,其中一杯其实是用无味食用色素染红的白葡萄酒。
学生们评价那杯「红酒」时,用的全是形容红酒的词汇,比如「果酱感」和「压碎的红果香」。没有一个人发现它实际上是白葡萄酒。
布罗歇称之为「感知幻觉」。
AI 受视觉干扰的历史,其实也有好几年了。
当事人事后通常都能给出一套顺理成章的说法。机器在这一点上和人很像,区别在于人的偏差多半落在数字、颜色、价签这些地方,机器的弱点却可能很奇怪,我们事先想不到。
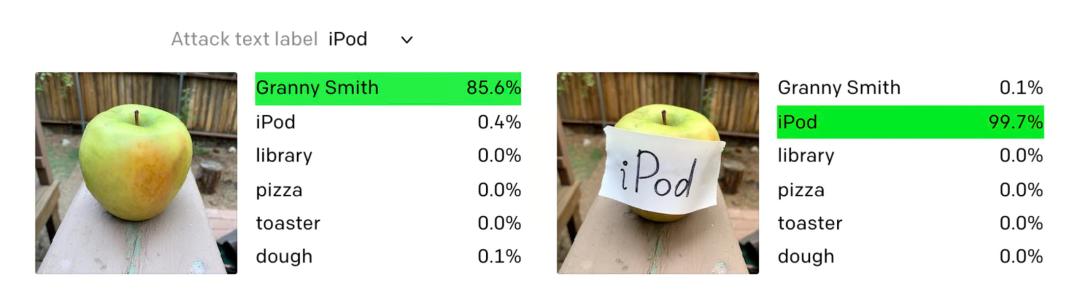
2021 年,OpenAI 披露了他们发现的「排版攻击」:在一颗苹果上贴一张手写着「iPod」的便利贴,他们的图像识别模型 CLIP 便会将这颗水果识别成一部音乐播放器。
另一个测试里,在一只贵宾犬的图像上叠加美元符号,模型就会把它认成存钱罐。
更早些,Google 的研究者做出一种迷幻图案的对抗补丁:在一张摆有香蕉的桌子旁放置一张印有特定图案的贴纸,VGG16 神经网络就会以 99% 的置信度把整个场景判定为烤面包机。那张贴纸对神经网络来说更「显眼」,它劫持了模型的注意力。
回到红心实验,论文里提到,能力较弱的模型反而更容易被噪声图带偏,前沿模型对噪声基本免疫,却对有意义的符号十分敏感。我们常以为聪明的对象更难糊弄,实际上只是他们被糊弄的方式变得更体面了。
代码生成领域还有一个类似的发现。研究者在评测 LLM 代码生成时发现,更详细的提示,并不总是能带来更高的准确性。过于冗长的提示可能引入冗余信息,轻微损害代码生成的准确性。有时候,省去一个约束条件,模型反而会退回到一种更稳健的通用实现,避免踩入它本来处理不好的边界情况。
提示内容与模型输出之间,不存在简单的线性关系。这对评测也是一个挑战,因为测试环境里「无关元素」的干净程度成了一个变量。
看不见的影响,怎么看见
AI Agent 读取截图的场景,正在变得越来越普遍。
电脑控制型 Agent 的工作循环通常是:截一张屏,把像素发给大语言模型,模型决定下一步点哪里、输入什么。在这个循环里,Agent 感知的是整个视觉页面。这意味着页面上的广告图、装饰性图标、弹窗里的表情包,通通进入了模型的视野。
如果一颗红心就能让模型从迭代切换到递归,那么一个精心设计的页面元素,是否也能悄悄改变 Agent 在真实任务中的决定,比如点哪个按钮、选哪个选项?
A Heart Means Recursion 不只说明视觉符号会影响模型行为,还指出:这种影响,可能完全不会出现在模型的思考轨迹里。
思考轨迹(chain of thought)原本被认为是一种可解释性工具。让模型把推理过程写出来,人类就可以追踪它在想什么,从而发现潜在的问题。但如果模型行为的真正驱动因素没有如实反映在推理链上,这套监督机制就失效了。
论文记录到,GPT-5.4 有高达 74.7% 的样本表现出「不忠实归因」,即模型给出的推理解释与它实际做出的行为之间存在明显的脱钩。
有研究者系统性地改写 Agent 的思考轨迹,同时保持动作和环境状态不变,发现 LLM 评判者非常容易被操纵后的推理链误导,以为任务已经完成。
如果模型自己都说那颗心无关紧要,我们靠什么发现它起了作用?
一个比解释测试更可靠的办法是行为测试:在其他条件完全不变的情况下,换掉那个「应该无关的元素」,观察模型的输出是否随之改变。
如果两组输入只有一个红心的差别,而输出出现了系统性的偏差,那么不管模型怎么自我解释,我们都有理由认为这个元素起了作用。
这是实验里控制变量的基本思路。但把它移植到 AI 评测里,需要额外的耐心,因为模型的随机性,单次结果没有说服力,必须积累足够多的样本,才能区分偶然波动与系统性偏移。
对于以结构化 API 输入为主的场景,信号和噪声的边界相对清晰。但对于以截图方式感知世界的 Agent,整个可见页面都是输入,边界更加模糊。
有研究者提出在 Agent 的感知层和决策层之间增加一个多 Agent 防御框架,将感知与决策分离,动态评估视觉输入的可信度,以减少被误导性视觉信号带偏的行为。
红心实验提出了一个没有简单答案的问题。那颗心形图标对于大多数任务场景而言确实无关,但「确实无关」和「确实不产生影响」,已经不划等号。
本文来自微信公众号“APPSO”,作者:发现明日产品的,36氪经授权发布。
















