从类药分子到靶点特异性化合物,美国匹兹堡大学利用分子指纹查询加速靶向药物发现
来自美国宾夕法尼亚州匹兹堡大学的研究团队提出了一种全谱生成式先导化合物发现流程,其核心是多尺度 DRUG-GAN 模型,能够在三个不同场景下,通过生成式模型指导药物分子的发现。在针对三类药理学特征各异的靶点开展的评估中,FSGLD 在识别靶点特异性候选化合物方面展现出良好的应用潜力。
传统药物发现是一项极具挑战性的工作,其核心目标是在庞大的化学空间中,识别出具有特定理想性质且能够作用于特定靶点的分子。从最初的研发构想到最终获得上市批准,一款新药的开发成本超过 26 亿美元,耗时超过 12 年。其中一个根本性挑战在于,如何在包含 1023-1060 个分子的庞大化学空间中高效搜索,从而找到同时具备目标生物活性、理化性质和可合成性的化合物。
近年来,生成式人工智能为分子设计带来了新的可能。通过学习已有分子的结构和性质,生成模型能够探索潜在的化学空间,提出具有特定理化性质或生物活性特征的候选分子。然而,如何将模型生成的分子转化为化学结构有效、实际可获取,并且具有真实生物活性的化合物,仍是这一领域面临的重要问题。
在此背景下,来自美国宾夕法尼亚州匹兹堡大学的研究团队提出了一种全谱生成式先导化合物发现(Full-Spectrum Generative Lead Discovery,FSGLD)流程,这是一种由深度学习驱动的高效药物先导化合物识别方法。FSGLD 的核心是多尺度 DRUG-GAN 模型,能够在三个不同场景下,通过生成式模型指导药物分子的发现,包括:
(1)生成随机的类药性化合物;
(2)生成具有靶点特异性的化合物;
(3)生成具有共同化学结构的靶点特异性系列化合物。
在针对三类药理学特征各异的靶点开展的评估中,FSGLD 在识别靶点特异性候选化合物方面展现出良好的应用潜力。此外,研究还建立了一套用于热力学积分(TI)计算的计算流程,在保持计算精度的同时,将计算时间缩短了 80% 至 90%。
相关研究成果以「A Full-Spectrum Generative Lead Discovery (FSGLD) pipeline via DRUG-GAN: A multiscale method for drug-like/target-specific compound library generation」为题,已刊登 ScienceAdvances。
研究亮点:
FSGLD 流程不仅可以利用生成式模型设计具有类药性和靶点特异性的化合物,还能对候选化合物进行系统、高效的筛选和验证
研究人员构建了一个具有实用性和可扩展性的框架,有望降低临床前药物发现所需的时间和成本
通过该流程生成的化合物并非仅停留在理论层面的候选分子,而是具备进一步开展实验验证的可行性,能够为学术研究人员和制药行业从业者带来切实价值
论文地址:https://www.science.org/doi/full/10.1126/sciadv.aei5257
数据集:针对三种应用场景的不同数据集
FSGLD 针对不同的先导化合物发现任务设计了三种应用场景,因此采用了不同的数据集和训练策略。
对于场景 I,研究人员依据 Lipinski 五规则并结合多样性筛选,从 DrugBank 数据库(https://go.drugbank.com/)中收集了 7,002 种药物,构建类药性化合物数据集。
对于诱饵分子集,研究人员使用 Open Babel 计算了 ZINC 数据库类药性子集中 19,212,639 个分子的分子量(MW)和脂水分配系数(logP)。随后,研究人员利用内部开发的程序,从中筛选出 284,552 种分子量和 logP 值与 DrugBank 化合物最为接近的 ZINC 化合物。接下来,使用 SYBYL-X 2.1.1 软件,基于分子指纹(FP)对这些化合物进行聚类,以最大限度地提高其结构多样性。最终,研究人员选取 9998 种分子,构建诱饵分子集。
为了训练和验证 dcGAN 的判别器,研究人员采用十折交叉验证方法([75]),将所有选定的类药性分子(7002种)和诱饵分子(9998种)划分为训练集和测试集。
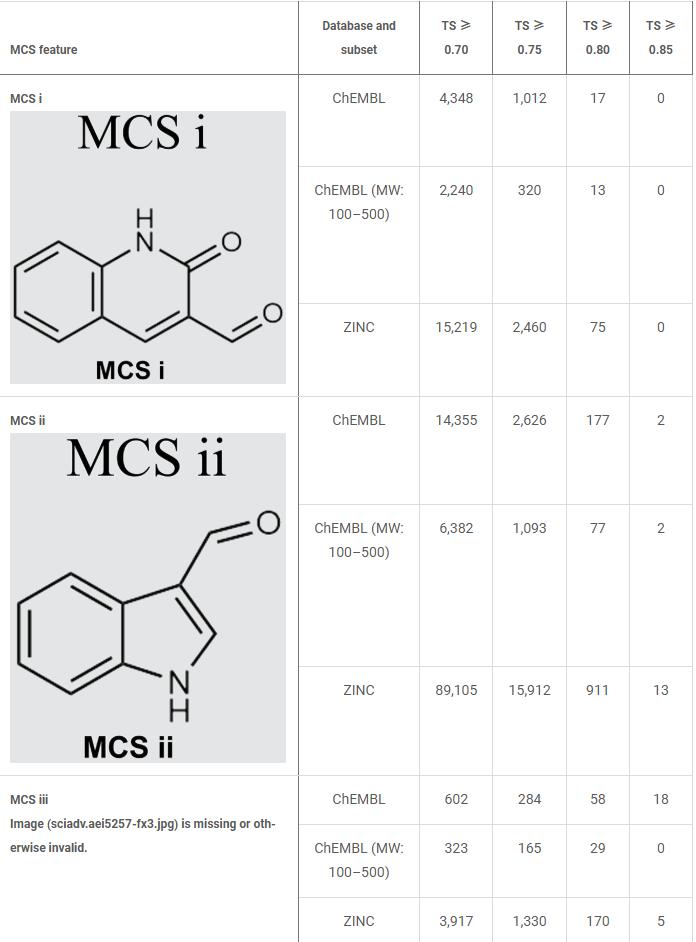
对于场景 II 和场景 III 中靶点偏向型化合物的生成,研究人员从 ChEMBL 数据库中收集了 1,896 种 CB2 活性化合物(Ki/IC50 低于100 nM)和 2996 种 CB2 非活性化合物(Ki/IC50 大于或等于100 nM),用于训练 cdcGAN 模型。此外,研究人员还对收集到的 CB2 活性化合物的化学结构进行了人工检查,并识别出其中最常见的三个最大公共子结构(MCS),如下表:
在模型训练过程中,所有分子均使用 Open Babel 2.3.1 版本软件转换为 MACCS 分子指纹(168位)。为了开展进一步验证,研究人员获取了 CB1 的 X 射线晶体结构,并构建了 CB2 的同源模型。
FSGLD 框架:以 DRUG-GAN 为核心
FSGLD 的核心是 DRUG-GAN,其关键思路并非直接生成完整分子结构,而是学习分子指纹的分布,生成具有特定特征的指纹,再将其作为查询条件,从大型化学数据库中检索结构相似的真实化合物,其流程概览如下所示:
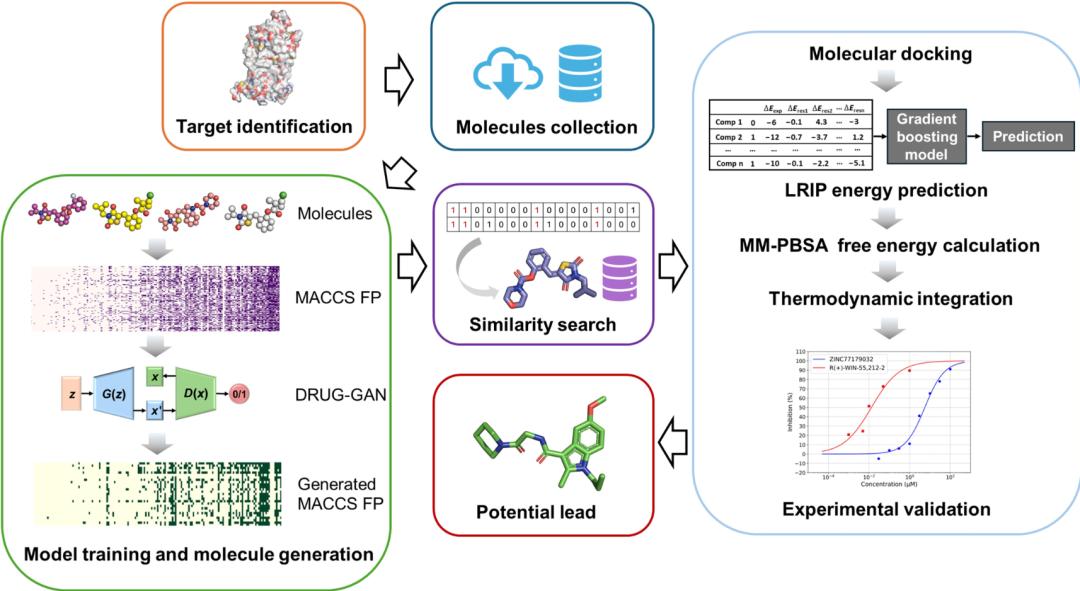
FSGLD 流程概览
这一设计与传统基于 SMILES 字符串或分子图的生成模型有所不同。MACCS 分子指纹能够以紧凑的形式描述分子的结构特征,适合从相对有限的数据集中学习。但由于分子指纹无法与单一分子建立唯一映射关系,也不能直接转换为化学有效的分子结构,因此,DRUG-GAN 生成的指纹需要进一步与 ChEMBL、ZINC 等数据库进行相似性匹配,才能获得实际的候选化合物。
从模型架构来看,研究人员采用深度卷积神经网络(DCNN)构建判别器,并索了四种主要的 DCNN 架构,分别为 LeNet-5、AlexNet、ZFNet 和 VGGNet。
根据不同的发现目标,DRUG-GAN 被设计为三种应用场景。
场景 I 采用标准 dcGAN,以 DrugBank 中的类药性分子指纹作为真实样本,学习类药性分子的特征分布。生成器从随机噪声出发,生成新的分子指纹,再通过相似性检索从 ZINC 数据库中寻找对应化合物。这一场景主要用于探索具有类药性特征的化学空间。
场景 II 进一步引入靶点特异性信息,采用条件生成对抗网络 cdcGAN。模型以 CB2 活性和非活性配体作为两类训练数据,学习与 CB2 活性相关的分子指纹特征,进而生成具有 CB2 靶点偏向性的指纹。随后,研究人员以生成指纹为查询条件,从 ChEMBL 和 ZINC 数据库中检索候选化合物,实现从无偏的类药性分子探索向靶点导向型发现的拓展。
场景 III 则进一步提高了分子设计的可控性。研究人员在生成器中引入掩码层(Mask Layer),具体通过 Lambda 层固定预定义 MCS 对应的分子指纹特征位,使生成的指纹保留指定结构特征,同时允许其他特征位发生变化。通过这一方式,模型能够生成兼具 CB2 靶点偏向性和特定骨架特征的化合物系列,为命中化合物扩展及后续先导化合物优化提供支持。
在候选化合物生成之后,FSGLD 还建立了分层计算筛选流程。首先通过分子对接评估候选分子与目标受体的结合情况,再利用靶点特异性LRIP评分函数进行筛选,随后开展分子动力学(MD)模拟、MM-PBSA结合自由能计算和热力学积分(TI)计算。只有通过当前阶段筛选的化合物,才能进入下一环节。最终,研究人员对优先级较高的候选分子开展实验验证,形成从生成、检索、计算筛选到实验评估的完整流程。
成果:在三类药理学特征各异的靶点评估中均表现良好
实验人员通过三种场景评估模型的表现:
场景 I:生成类药性化合物
研究人员从唯一性(Uniqueness)、新颖性(Novelty)、多样性(Diversity)、相似性(Similarity)和有效性(Validity)五个维度,对 DRUG-GAN 与三种已发表的生成式模型——ORGAN、OR(W)GAN 和 ORGANIC——进行了全面比较。
如下表,在 MACCS FP 空间中,DRUG-GAN 在多项关键指标上均优于作为基准的其他生成式模型。尤其是,DRUG-GAN 的唯一性和新颖性得分均达到1.00,取得了满分表现。这意味着所有生成的分子指纹彼此不同,且均未出现在训练数据中。其多样性得分为0.73,与 ORGAN(0.77)和 ORGANIC(0.76)的表现接近,同时高于 OR(W)GAN(0.63)。此外,DRUG-GAN 生成的分子指纹与 7002 个参考药物之间的平均相似性最低,仅为 0.25。这表明,该模型能够在保留类药性特征的同时,生成具有明显结构差异的分子指纹。
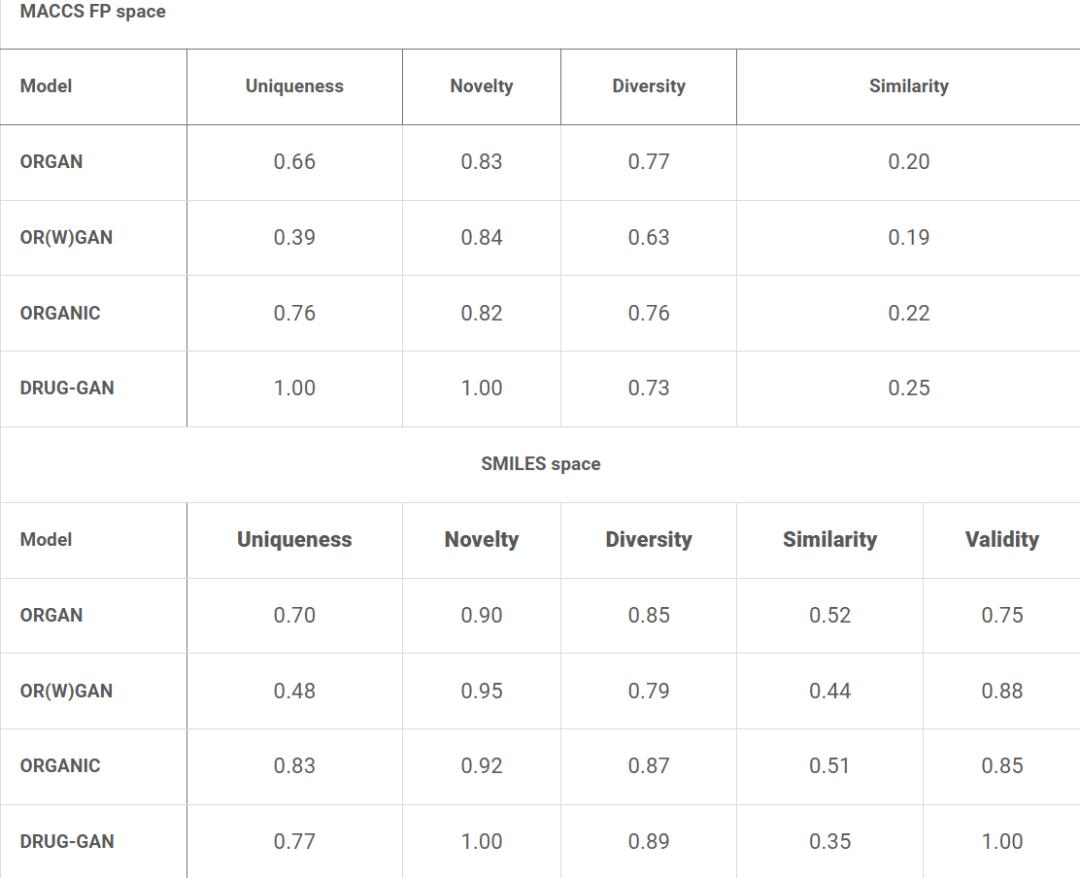
使用 10,000 个生成的样本在 FP 和 SMILES 空间中评估 DRUG-GAN 和已发表的生成模型
与 FP 空间评估结果一致,DRUG-GAN 在 SMILES 空间也表现出色。DRUG-GAN 的新颖性得分仍保持在1.00,表明解码得到的所有分子均未出现在训练数据集中。正如预期,由于多个不同的分子指纹可能解码为相同的分子结构,其唯一性得分从 FP 空间中的1.00下降至 SMILES 空间中的0.77。尽管如此,DRUG-GAN 的唯一性仍高于 ORGAN 和 OR(W)GAN,仅略低于 ORGANIC。同时,DRUG-GAN 还保持了较高的多样性,得分达到 0.89,而其生成分子与参考药物之间的相似性相对较低,得分为 0.35。这与该模型在不牺牲化学合理性的前提下拓展化学空间的设计目标一致。
为了进一步评估这些结果,研究人员还分析了 2252 种美国食品药品监督管理局(FDA)批准的药物,其分子量(MW)范围为 100 至 1000 Da。这些已获批药物的平均分子量(MW)、脂水分配系数对数值(logP)和拓扑极性表面积(TPSA)分别为 358.0 Da、2.8 和 89.3 Ų。DRUG-GAN 检索得到的分子则表现出与之相近的类药性特征,其平均分子量为 382.9 Da,平均 logP 为 2.0,平均 TPSA 为 76.0 Ų。这些数据表明,与 FDA 已批准药物相比,DRUG-GAN 检索得到的分子整体分子量略大,但极性相对较低,显示出潜在的有利理化性质。
场景 II:靶点特异性化合物生成
除了生成具有类药性的候选化合物,DRUG-GAN 还具备生成靶点特异性化合物的能力。为展示这一能力,研究人员以大麻素受体2(CB2)为例开展研究。
在与生成的分子指纹相似性达到 85% 或以上(TS ≥ 0.85)的 186 个 ChEMBL 化合物中,有 169 个化合物的分子量(MW)介于 100 至 500 Da 之间,其中 104 个化合物已在生物活性实验中被报道为具有 CB2 活性的配体,其抑制常数(Ki)小于10 μM。检索得到的化合物中,低 Ki 值分子的富集表明,DRUG-GAN 生成的分子指纹查询能够有效地从与目标靶点相关的生物活性数据库中,检索出已知具有 CB2 活性的化学结构类型。此外,研究人员还从 ZINC 数据库中检索到 161 个化合物,其与 DRUG-GAN 生成的分子指纹查询之间的 TS 均达到或超过 0.85。
随后,研究人员将检索得到的化合物分别与 CB1 和 CB2 受体进行分子对接,预测其结合亲和力,结果如下图:
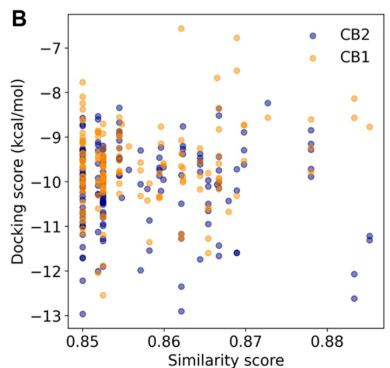
在指定 TS 阈值下检索到的 ZINC 化合物与 CB1 和 CB2 受体的预测对接评分
总体而言,DRUG-GAN 生成的分子指纹查询所检索得到的化合物,对 CB2 表现出较好的预测结合能力,其与 CB2 受体分子对接得分的平均值为 −10.10 kcal/mol,优于场景 I 判别器训练所用诱饵分子的平均值 −8.29 kcal/mol。对每个检索化合物的对接得分进行配对比较后,研究人员进一步发现,这些化合物整体上表现出对 CB2 的结合偏好,其中相当一部分化合物与 CB2 的预测结合能力优于与 CB1 的结合能力。
场景 III:靶点特异性系列化合物生成
在场景三中,研究人员将三个预定义 MCS 引入生成器,通过掩码层生成具有特定骨架约束的 CB2 候选化合物。
MCS i:喹啉二酮核心结构
对于 MCS i,研究人员从 ChEMBL 数据库中检索并确认了 49 个包含预定义子结构、且与生成的分子指纹查询之间 TS ≥ 0.75 的化合物。如下图,有 7 个化合物已被报道具有较高的 CB2 活性(Ki 小于10 μM)。
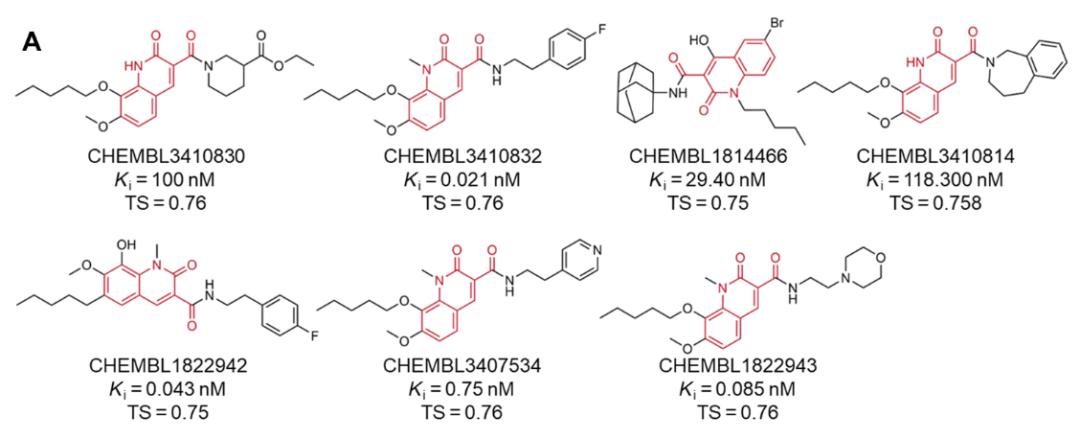
含有 MCS i 的排名靠前的化合物
在 ZINC 数据库中,研究人员则检索并确认了32个包含 MCS i 子结构、且 TS ≥ 0.75 的化合物,部分具有代表性的候选化合物及其对应的 TS 值如下图:
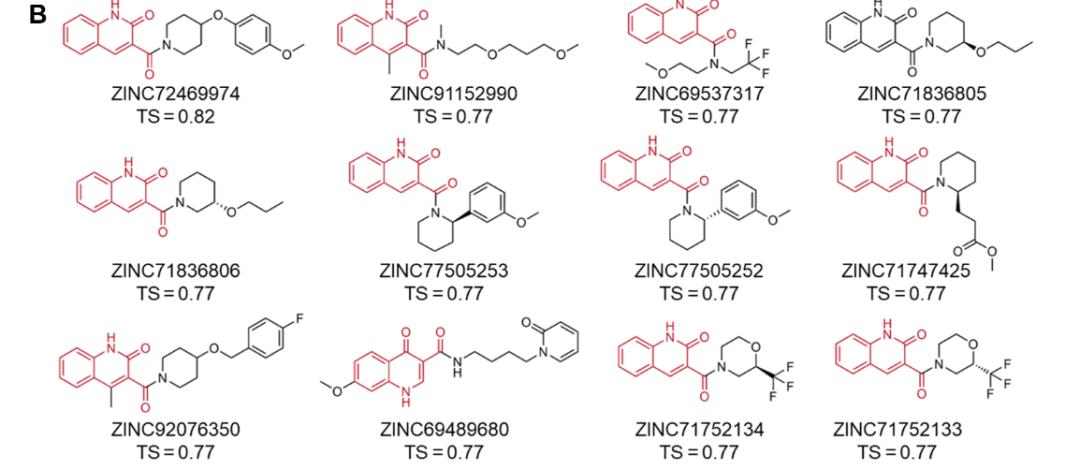
含有 MCS i 的排名靠前的化合物
这些候选化合物中的大多数,其与 CB2 的预测分子对接得分优于与 CB1 的对接得分,表明它们在基于分子对接的候选化合物优先级排序中可能具有 CB2 结合偏好。
MCS ii:吲哚甲酰胺核心结构
对于 MCS ii,研究人员从 ChEMBL 数据库中检索并确认了 24 个包含预定义子结构、且与生成的分子指纹查询之间 TS ≥ 0.80 的化合物。其中,有 8 个化合物表现出较强的 CB2 结合亲和力(如下图),进一步证明了骨架约束型 DRUG-GAN 策略能够有效检索与 CB2 相关的化学结构类型。
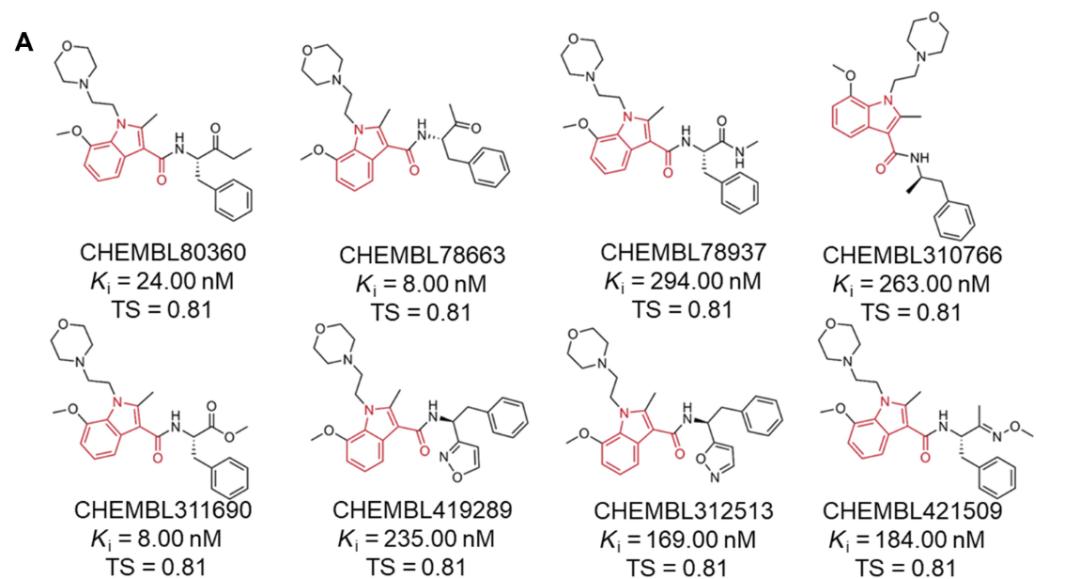
含有 MCS ii 的排名靠前的化合物
在 ZINC 数据库中,研究人员则发现了 9 个包含 MCS ii 子结构、且 TS ≥ 0.80 的化合物(如下图)。与 MCS i 的候选化合物类似,这些化合物中的大多数,其与 CB2 的预测分子对接得分也优于与 CB1 的对接得分,表明它们具有进一步开展 CB2 靶向筛选的潜力。
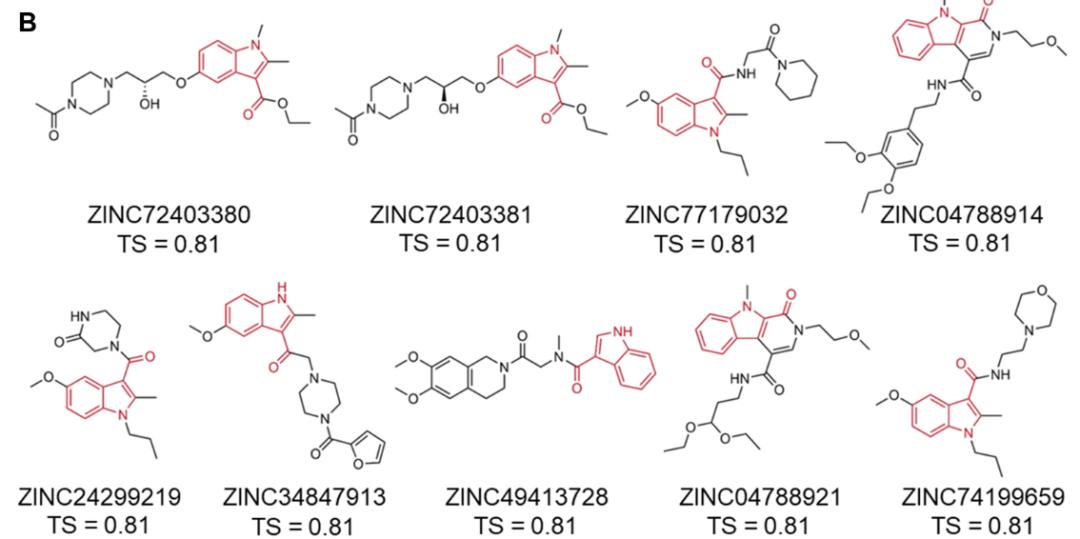
含有 MCS ii 的排名靠前的化合物
MCS iii:吲哚磺酰胺骨架
对于 MCS iii,研究人员最初在 TS ≥ 0.75 的条件下,从 ChEMBL 数据库中检索到了 165 个化合物。然而,通过 FP2 分子指纹分析,最终仅有 2 个化合物被确认包含完全匹配的 MCS iii 子结构(如下图)。
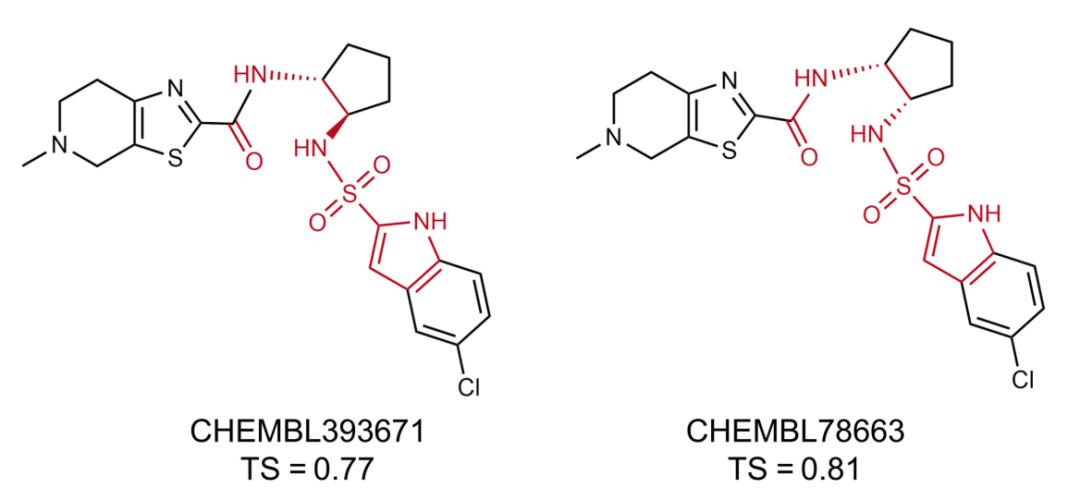
从 ChEMBL 数据库中检索到的含有 MCS iii 的 CB2 受体的排名最高的化合物
此外,在 ZINC 数据库中,所有 TS ≥ 0.75 的检索化合物均未能通过验证,即没有任何化合物被确认包含完全匹配的 MCS iii 子结构。
综合结果表明,骨架约束型 DRUG-GAN 策略能够在保留与 CB2 相关的化学结构特征的同时,拓展训练配体所代表的化学空间,发现具有结构差异的新候选化合物。
结语
为了优先筛选出具有潜力的候选化合物,FSGLD 采用分层工作流程对检索得到的化合物进行评估,包括分子对接、靶点特异性 LRIP 评分、分子动力学(MD)模拟、MM-PBSA 结合自由能计算以及热力学积分计算,并对部分候选化合物开展实验验证。通过将这些互补的方法整合到统一的工作流程中,FSGLD 为优先筛选候选先导化合物、并为后续实验评估提供依据,建立了一套实用的研究框架。
随着蛋白质结构预测和协同折叠方法不断发展,研究人员预计 FSGLD 框架的准确性、稳健性和适用范围也将相应得到提升。未来研究将进一步在更广泛的靶点家族中评估 DRUG-GAN 和 FSGLD,包括离子通道和核受体等,同时引入先进的小样本学习和小数据集学习策略,以进一步提升模型在数据有限场景下的表现。
参考文献:https://www.science.org/doi/full/10.1126/sciadv.aei5257
本文来自微信公众号“HyperAI超神经”,作者:HyperAI,36氪经授权发布。
















